1. Tensor란 무엇인가
Tensor는 PyTorch에서 데이터를 저장하고 연산하는 기본 자료구조다.
NumPy의 ndarray와 비슷하지만 GPU로 이동할 수 있고, 자동 미분을 이용한 딥러닝 학습에 사용할 수 있다.
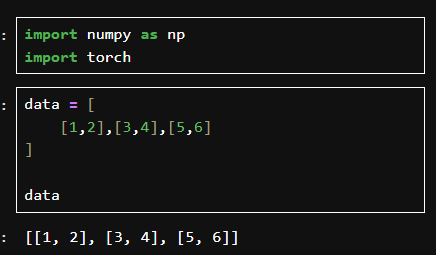
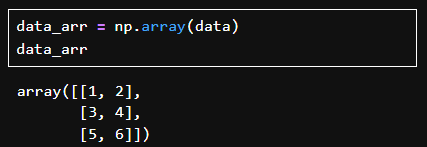

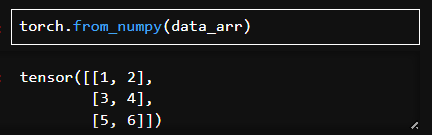
Python List와 NumPy Array를 모두 Tensor로 바꿀 수 있다.
`torch.from_numpy()`로 만든 Tensor는 조건에 따라 원본 NumPy Array와 메모리를 공유하므로 한쪽의 변경이 다른 쪽에 반영될 수 있다.
⠀
2. Shape과 Dimension
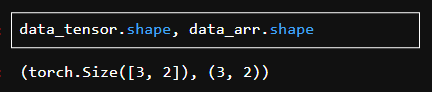
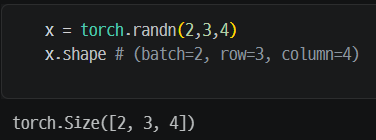
3은 행의 개수이고 2는 열의 개수다.
`(3, 2)`를 3차원이라고 생각하기 쉽지만, Shape에 숫자가 두 개이므로 2차원 Tensor다.
| Shape | Dimension | 해석 |
| (3,) | 1차원 | 원소 3개인 Vector |
| (3, 2) | 2차원 | 3행 2열 Matrix |
| (2, 3, 4) | 3차원 | 크기 3×4인 Matrix가 2개 |
📌 이해 보충 | 차원 수는 Shape 안에 있는 숫자의 개수이고, 각 숫자는 그 차원의 크기다.
`(10, 3, 5)`의 첫 번째 값 10이 크다고 해서 10차원이 되는 것은 아니다.
⠀
3. Tensor 생성 함수
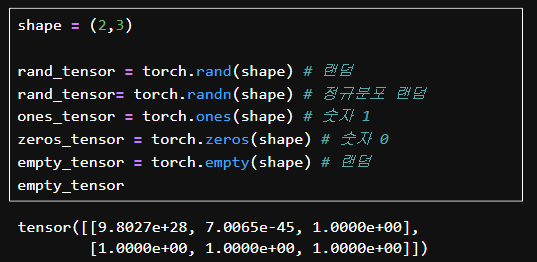
| 함수 | 생성되는 값 |
| torch.rand | 0 이상 1 미만의 균등분포 난수 |
| torch.randn | 평균 0 표준편차 1의 표준정규분포 난수 |
| torch.ones | 모든 원소가 1 |
| torch.zeros | 모든 원소가 0 |
| torch.empty | 초기화하지 않은 메모리 공간 |
⚠ 정확성 보완 | `torch.empty()`의 출력에 숫자가 보이더라도 랜덤값을 생성한 것이 아니다.
메모리에 남아 있던 값이 보일 수 있으므로 값을 채우기 전에 사용하면 안 된다.
⠀
4. Shape dtype device
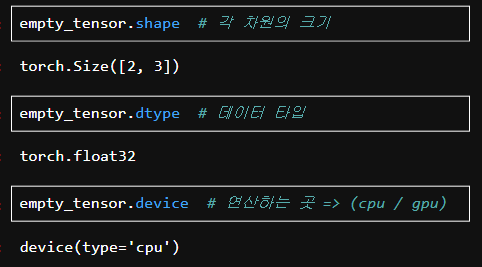
| 속성 | 확인하는 정보 |
| shape | 각 차원의 크기 |
| dtype | float32 int64 같은 데이터 타입 |
| device | CPU 또는 CUDA GPU 중 Tensor가 위치한 장치 |
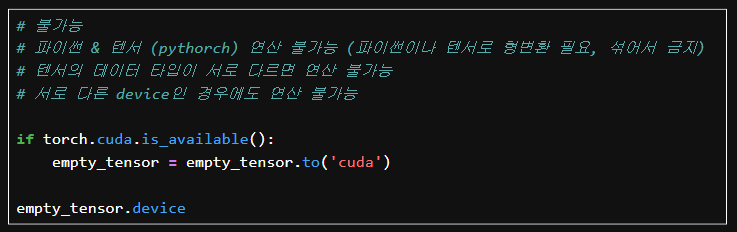
📌 이해 보충 | 모델의 Weight와 입력 Tensor는 서로 계산할 때 직접 만나야 하므로 같은 장치의 메모리에 있어야 한다.
예를 들어 모델은 GPU에 있고 입력 데이터는 CPU에 있으면 서로 다른 메모리에 저장되어 있어 바로 연산할 수 없다.
따라서 model.to(device)와 tensor.to(device)를 사용해 둘을 모두 CPU 또는 모두 GPU로 맞춰야 한다.
⠀
5. Indexing
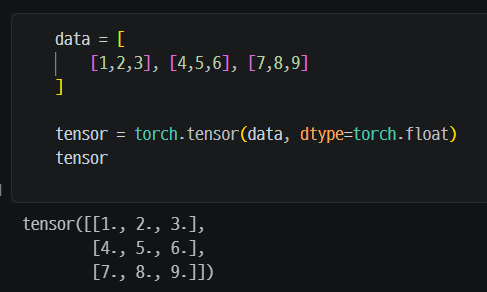
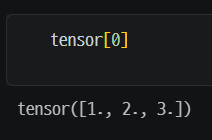
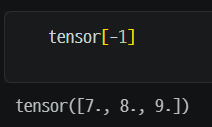
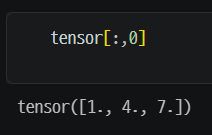

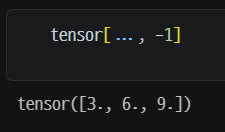
쉼표 앞은 행, 뒤는 열을 선택한다.
`:`는 해당 차원의 모든 값을 의미하고, `...`은 앞쪽 차원을 그대로 유지한 채 뒤에서 지정한 차원을 선택한다.
⠀
6. cat과 stack
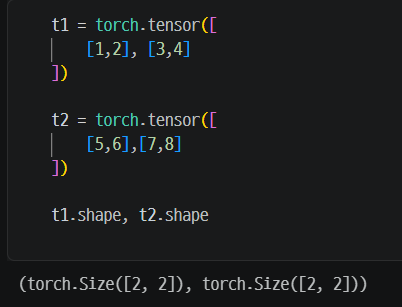

| 함수 | 차원 변화 | 핵심 |
| cat | 차원 수 유지 | 기존 차원 중 하나를 따라 이어 붙임 |
| stack | 차원 수 1 증가 | 새로운 차원을 만든 뒤 Tensor를 쌓음 |
⠀
7. Matrix Multiplication
2차원 Matrix Multiplication에서는 앞 Matrix의 열 수와 뒤 Matrix의 행 수가 같아야 한다.
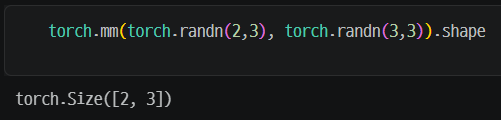
`(2, 3) × (3, 3)`에서는 안쪽의 3과 3이 같아 계산할 수 있고, 결과 Shape은 바깥쪽 숫자인 `(2, 3)`이 된다.
⠀
8. Batch Matrix Multiplication
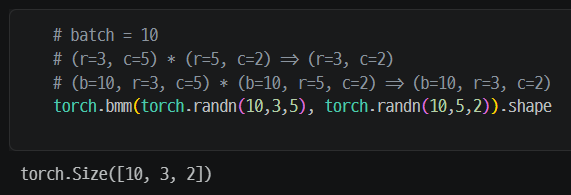
10개의 `(3, 5) × (5, 2)` Matrix Multiplication을 Batch 단위로 계산한 것이다.
Batch 크기 10은 그대로 유지되고, 뒤쪽 두 차원에서 Matrix Multiplication이 수행된다.
⠀
9. item과 In place 연산
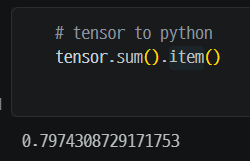
`.item()`은 원소가 하나인 Tensor에서 Python 숫자를 꺼낸다.
Random Index처럼 Python 정수가 필요한 곳에서 자주 사용한다.
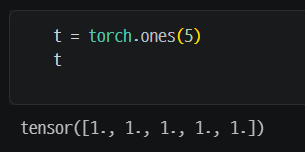
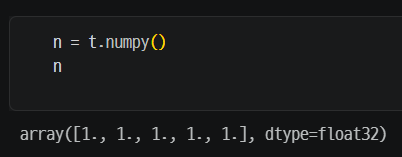
# t와 n이 메모리를 공유하면 둘 다 바뀔 수 있음
📌 이해 보충 | 함수 이름 끝의 `_`는 기존 Tensor 자체를 바꾸는 In place 연산을 뜻한다.
원본이 필요한 경우에는 무심코 사용하지 않도록 주의한다.
⠀
10. reshape와 permute
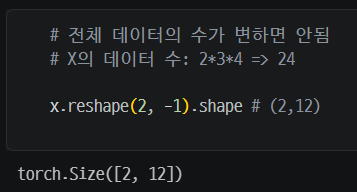

| 함수 | 무엇을 바꾸는가 | 조건 |
| reshape | 전체 원소를 다른 Shape으로 재구성 | 전후 원소 수가 같아야 함 |
| permute | 기존 차원의 순서 | 모든 차원 번호를 한 번씩 지정 |
reshape() : 괄호 안에 적힌 항목의 개수가 결과의 차원 수가 되고, -1은 그중 한 자리의 크기만 자동으로 계산한다.
permute(0, 2, 1) : 기존 차원을 0번 → 2번 → 1번 순서로 재배치한다.
⠀
11. unsqueeze와 squeeze

x.unsqueeze(0).shape # (1, 2, 3, 4)
x.unsqueeze(1).shape # (2, 1, 3, 4)
x.unsqueeze(-1).shape # (2, 3, 4, 1)
`unsqueeze()`는 지정한 위치에 크기 1인 새 차원을 추가한다.
반대로 `squeeze()`는 크기가 1인 차원을 제거한다.
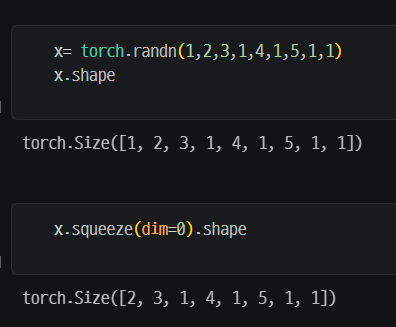
📌 이해 보충 | `squeeze(dim=1)`처럼 차원을 지정했더라도
해당 차원의 크기가 1이 아니면 제거되지 않고 원래 Shape이 그대로 반환된다.
⠀
핵심 정리
| 코드 | 역할 |
| torch.tensor | Python 데이터에서 Tensor 생성 |
| torch.from_numpy | NumPy Array를 Tensor로 변환 |
| shape dtype device | Tensor의 구조 타입 장치 확인 |
| cat stack | 기존 차원 연결 또는 새 차원으로 쌓기 |
| mm bmm | 2차원 또는 Batch Matrix Multiplication |
| item | 원소 하나인 Tensor를 Python 값으로 변환 |
| reshape permute | Shape 재구성 또는 차원 순서 변경 |
| unsqueeze squeeze | 크기 1인 차원 추가 또는 제거 |
'개발 공부 > 딥러닝' 카테고리의 다른 글
| [Deep Learning] 표 데이터와 시계열 데이터도 Dataset으로 만들기 (0) | 2026.09.25 |
|---|---|
| [Deep Learning] PyTorch Custom Dataset 만들기 (0) | 2026.09.25 |
| [Deep Learning] Hugging Face란? (0) | 2026.09.24 |
| [Deep Learning] PyTorch Dataset과 DataLoader (0) | 2026.09.24 |
| [Deep Learning] 딥러닝 (0) | 2026.09.15 |