1. 왜 Custom Dataset이 필요한가
FashionMNIST처럼 PyTorch가 제공하는 데이터는 한 줄로 불러올 수 있다.
하지만 실제 프로젝트에서는 내 폴더에 저장된 이미지나 회사에서 받은 파일을 사용해야 한다.
이때 모델이 데이터를 같은 방식으로 꺼낼 수 있도록 Dataset 규칙에 맞춰 감싸야 한다.
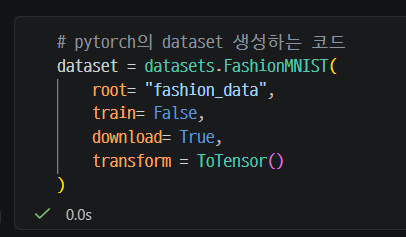
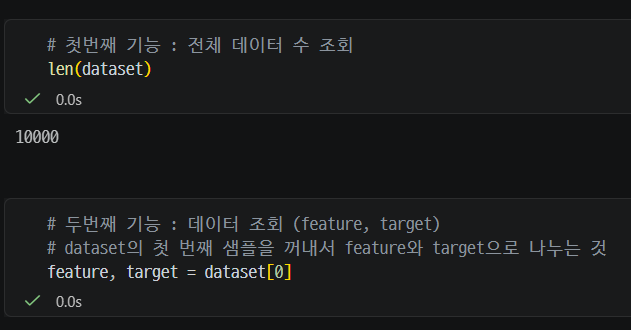
`len(dataset)`과 `dataset[0]`이 자연스럽게 동작하는 이유는 Dataset 내부에 두 기능이 구현되어 있기 때문이다.
직접 Dataset을 만들 때도 이 약속을 그대로 지키면 된다.
⠀
ImageFolder가 있는데도 직접 만드는 이유
폴더 이름이 곧 클래스이고 모든 이미지가 같은 규칙으로 정리되어 있다면 `ImageFolder`만으로 충분하다.
하지만 실제 데이터는 파일명에서 정답을 읽거나, CSV의 값과 이미지를 연결하거나, 한 샘플을 꺼낼 때 추가 전처리를 해야 할 수 있다. 이런 규칙을 직접 정해야 할 때 Custom Dataset이 필요하다.
| 구분 | ImageFolder | Custom Dataset |
| 정답 생성 | 부모 폴더 이름을 자동 사용 | 원하는 규칙으로 직접 생성 |
| 파일 구조 | 클래스별 폴더 구조 필요 | 프로젝트 구조에 맞게 설계 가능 |
| 적합한 상황 | 정형화된 이미지 분류 | 이미지 CSV 시계열 등 사용자 데이터 |
📌 이해 보충 | Custom Dataset을 쓴다고 모델 학습 방식이 달라지는 것은 아니다.
데이터를 꺼내는 규칙만 직접 만들고, 완성된 Dataset은 똑같이 DataLoader에 전달한다.
⠀
Dataset이 반드시 제공해야 하는 두 기능
| 기능 | 직접 구현할 메서드 | 반환값 |
| 전체 데이터 수 | __len__() | 정수 |
| 특정 데이터 조회 | __getitem__(index) | feature와 target |
📌 이해 보충 | __len__과 __getitem__은 이름을 직접 호출하지 않아도 len(dataset), dataset[index] 문법과 연결된다.
앞뒤에 밑줄이 두 개 붙는 이유도 이런 특별한 동작을 정의하는 매직 메서드이기 때문이다.
⠀
2. 이미지 폴더 구조가 feature와 target을 결정한다
data/pizza_steak_sushi/
├── train/
│ ├── pizza/ ── *.jpg
│ ├── steak/ ── *.jpg
│ └── sushi/ ── *.jpg
└── test/
├── pizza/ ── *.jpg
├── steak/ ── *.jpg
└── sushi/ ── *.jpg
이미지 분류에서는 이미지 파일 자체가 feature이고, 그 이미지가 들어 있는 부모 폴더 이름이 target이다.
예를 들어 `train/sushi/123.jpg`라면 `123.jpg`가 feature이고 `sushi`가 target이 된다.
⠀
Path 객체로 경로 만들기
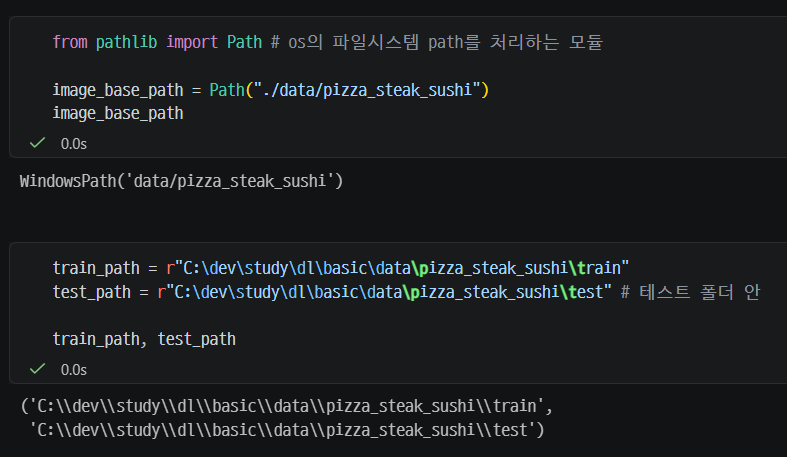
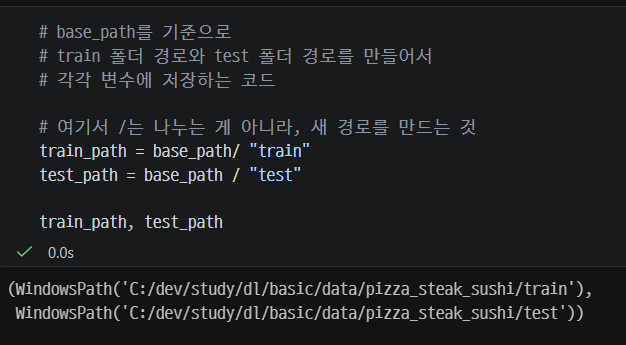
`Path`에서 `/`는 숫자를 나누는 연산이 아니라 하위 경로를 연결하는 연산이다.
따라서 `base_path / "train"`은 현재 데이터 폴더 아래의 train 폴더를 가리킨다.
📌 이해 보충 | `.`은 현재 작업 폴더를 뜻한다. `./data`는 현재 작업 폴더 안의 data 폴더다. 현재 작업 폴더가 달라지면 같은 코드라도 찾는 위치가 달라질 수 있다.
⠀
os.walk와 glob의 역할
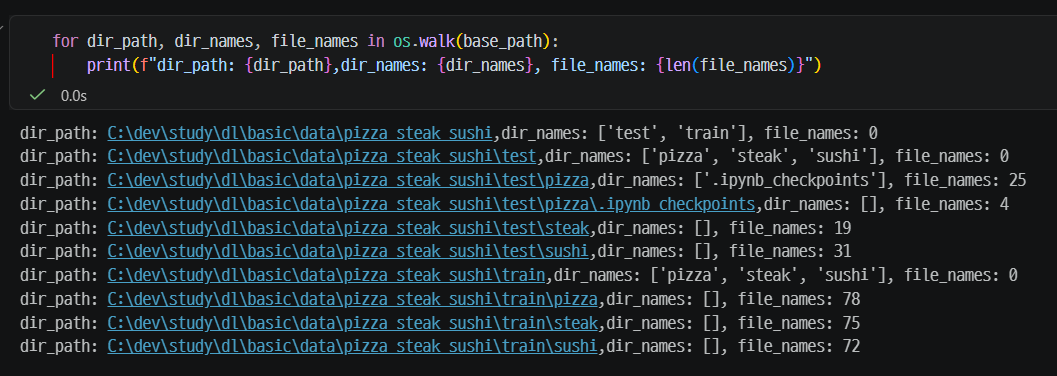
`os.walk()`는 현재 폴더 경로, 그 안의 하위 폴더 이름, 파일 이름을 차례로 꺼낸다.
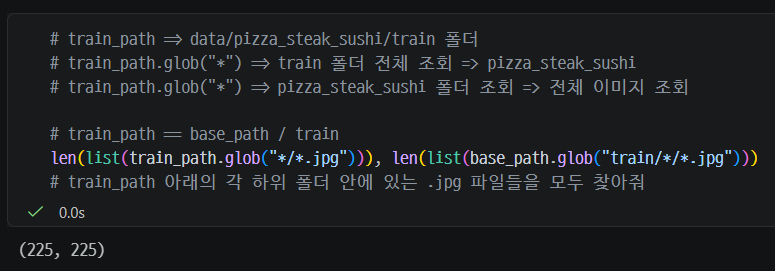
반면 `glob()`은 원하는 패턴에 맞는 경로만 골라낸다.
| 패턴 | 의미 | 예시 결과 |
| * | 현재 위치의 모든 항목 | pizza, steak, sushi 폴더 |
| */*.jpg | 한 단계 아래 폴더에 있는 jpg | 각 클래스 폴더의 이미지 |
📌 이해 보충 | `glob()`의 결과는 바로 데이터 개수가 아니라 경로를 하나씩 꺼내는 객체다.
개수를 세거나 인덱싱하려면 `list(...)`로 바꾼 뒤 `len()`을 사용한다.
⠀
3. ImageFolder로 먼저 확인하기
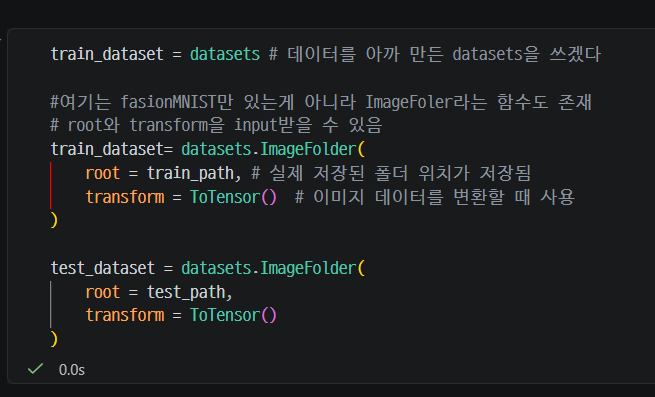
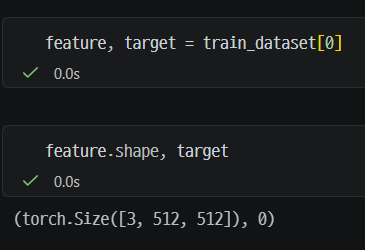
`ImageFolder`는 폴더 이름을 클래스 이름으로 보고 자동으로 숫자 라벨을 만든다.
첫 번째 샘플의 shape이 `(3, 512, 512)`라면 컬러 채널 3개, 세로 512픽셀, 가로 512픽셀인 이미지다.
target `0`은 클래스 이름을 숫자로 바꾼 결과다.
⠀
왜 화면에 출력할 때 permute가 필요한가
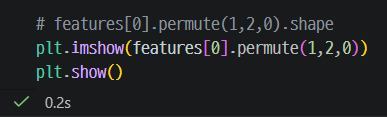
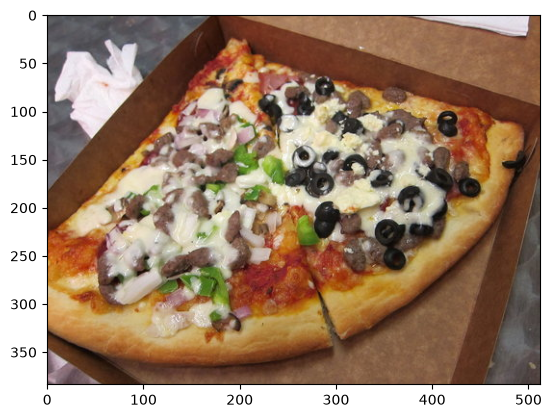
PyTorch 이미지는 `(C, H, W)` 순서지만 Matplotlib 컬러 이미지는 `(H, W, C)` 순서를 기대한다. `permute(1, 2, 0)`은 기존 1번 높이, 2번 너비, 0번 채널 차원을 그 순서대로 재배치한다.
⠀
DataLoader에서 이미지 크기가 왜 중요할까
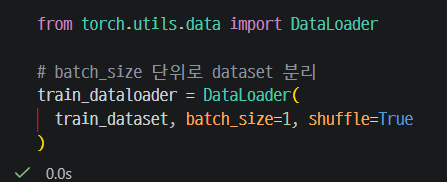
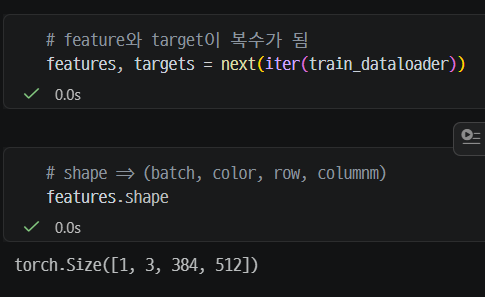
DataLoader는 여러 샘플을 하나의 Tensor로 쌓아 Batch를 만든다. 이미지마다 높이와 너비가 다르면 `batch_size`가 2 이상일 때 하나의 직사각형 Tensor로 쌓을 수 없다. 아직 Resize를 적용하지 않은 상태에서는 `batch_size=1`로 확인할 수 있다.
⚠ 주의 | 실제 학습에서 batch_size를 키우려면 모든 이미지의 H와 W를 같은 크기로 맞추는 Resize 등의 전처리가 필요하다.
⠀
4. Custom Dataset의 뼈대 만들기
from torch.utils.data import Dataset
class MyDataset(Dataset):
def __init__(self, dir_path, transform=None):
pass
def __len__(self):
pass
def __getitem__(self, idx):
pass
`Dataset`을 상속하면 PyTorch가 기대하는 Dataset 형태를 만들 수 있다.
세 메서드의 역할을 먼저 구분하면 코드가 덜 복잡해진다.
| 메서드 | 언제 실행되는가 | 할 일 |
| __init__ | 객체 생성 시 한 번 | 경로 목록 라벨 변환 함수 저장 |
| __len__ | len(dataset) 호출 시 | 전체 샘플 수 반환 |
| __getitem__ | dataset[idx] 호출 시 | idx번째 feature와 target 반환 |
⠀
__init__에서 반복 사용할 정보를 저장한다
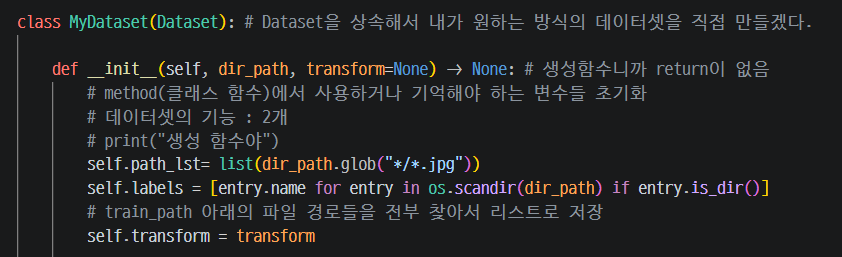
전체 이미지 경로는 `__len__`과 `__getitem__` 양쪽에서 사용한다.
클래스 폴더 이름과 transform도 계속 필요하므로 객체 속성으로 저장한다.
📌 이해 보충 | 여기서 `self`는 생성된 Dataset 객체 자신이다. `self.path_lst`로 저장하면 `__init__()`이 끝난 뒤에도 같은 객체의 `__len__()`과 `__getitem__()`이 그 값을 다시 사용할 수 있다.
⠀
__len__은 경로 목록의 길이를 반환한다
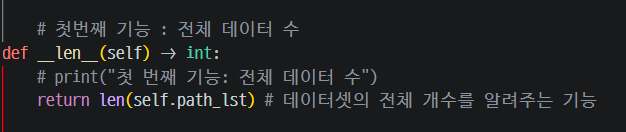
이미지 경로 하나가 샘플 하나를 뜻하므로 경로 목록의 길이가 Dataset의 전체 크기다. 이 구현에서는 `len(train_dataset)`이 `225`가 된다.
⠀
__getitem__은 하나의 feature와 target을 만든다
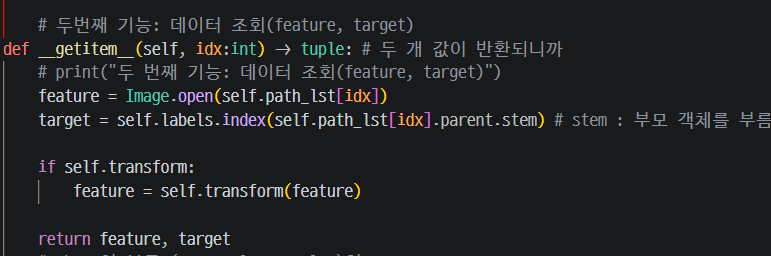
`self.path_lst[idx]`는 idx번째 이미지 경로다.
`Image.open()`으로 파일을 실제 이미지 객체로 열고,
`parent.stem`으로 부모 폴더 이름을 얻는다.
부모 폴더가 `sushi`이고 labels가 `['pizza', 'steak', 'sushi']`라면 `labels.index('sushi')`는 `2`를 반환한다.
📌 이해 보충 | 모델은 'sushi'라는 문자열을 정답으로 계산할 수 없다. 그래서 문자열 클래스 이름을 0, 1, 2와 같은 숫자 인덱스로 바꾼다.
transform이 전달되었을 때만 이미지에 적용하는 이유는 같은 Dataset 클래스를 상황에 따라 재사용하기 위해서다. `ToTensor()`를 넣으면 Tensor가 반환되고, 넣지 않으면 PIL Image가 반환된다.
⠀
dataset 0을 실행하면 내부에서 무슨 일이 일어날까
`train_dataset[0]`은 단순히 리스트의 첫 값을 보는 문법이 아니다.
Python이 `train_dataset.__getitem__(0)`을 호출하고, 그 안에서 첫 번째 경로를 이미지와 숫자 Label로 바꾼다.
| 순서 | 실행되는 코드 | 예시 결과 |
| 1 | self.path_lst[0] | 첫 번째 jpg 경로 선택 |
| 2 | Image.open(path) | PIL 이미지 객체 생성 |
| 3 | path.parent.stem | pizza |
| 4 | self.labels.index('pizza') | 0 |
| 5 | self.transform(feature) | PIL Image를 Tensor로 변환 |
| 6 | return feature target | 이미지 Tensor와 0 반환 |
📌 이해 보충 | 예를 들어 `path_lst[0]`의 부모 폴더가 pizza라면 target은 0이 된다.
첫 번째 샘플이라서 무조건 0인 것이 아니라, 해당 이미지의 폴더 이름이 `labels[0]`인 pizza이기 때문에 0이다.
⠀
5. 전체 Custom Dataset 코드
from pathlib import Path
from PIL import Image
from torch.utils.data import Dataset
import os
class MyDataset(Dataset):
def __init__(self, dir_path, transform=None):
self.path_lst = list(dir_path.glob("*/*.jpg"))
self.labels = [
entry.name for entry in os.scandir(dir_path)
if entry.is_dir()
]
self.transform = transform
def __len__(self):
return len(self.path_lst)
def __getitem__(self, idx):
feature = Image.open(self.path_lst[idx])
class_name = self.path_lst[idx].parent.stem
target = self.labels.index(class_name)
if self.transform:
feature = self.transform(feature)
return feature, target
⠀
객체 생성과 실행 결과
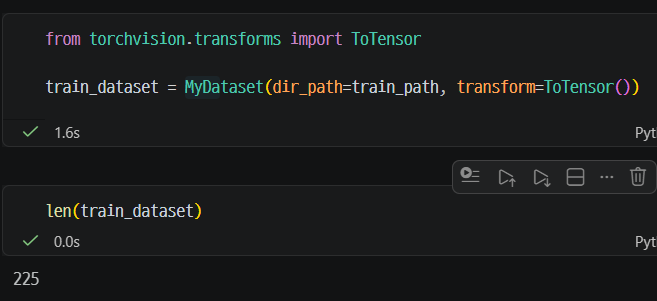
feature.shape, target
# (torch.Size([3, 512, 512]), 0)
`MyDataset`은 직접 만든 클래스지만 사용 방법은 FashionMNIST나 ImageFolder와 같다.
이 공통 인터페이스 덕분에 DataLoader에도 그대로 전달할 수 있다.
| 실행 결과 | 뜻 |
| 225 | train 폴더에서 찾은 전체 jpg 샘플 수 |
| 3 | RGB 색상 채널 수 |
| 512 512 | 첫 번째 이미지의 높이와 너비 |
| target 0 | 첫 번째 이미지의 클래스가 labels[0]인 pizza |
⠀
6. 핵심 정리
| 코드 | 역할 |
| Path / glob | 파일과 폴더 경로 수집 |
| Image.open | 경로의 이미지 파일 열기 |
| parent.stem | 부모 폴더 이름으로 클래스 확인 |
| __len__ | 전체 샘플 수 반환 |
| __getitem__ | 한 샘플의 feature와 target 반환 |
| transform | 필요할 때 이미지 전처리 적용 |
| DataLoader | Dataset을 Batch 단위로 공급 |
이번 글을 한 문장으로 정리하면, Custom Dataset은 저장 형식이 다른 원본 데이터를 `dataset[index] -> (feature, target)`이라는 공통 규칙으로 바꾸는 도구다.
'개발 공부 > 딥러닝' 카테고리의 다른 글
| [Deep Learning] 시계열 Dataset에 MinMax Scaling 적용하기 (0) | 2026.09.26 |
|---|---|
| [Deep Learning] 표 데이터와 시계열 데이터도 Dataset으로 만들기 (0) | 2026.09.25 |
| [Deep Learning] Hugging Face란? (0) | 2026.09.24 |
| [Deep Learning] PyTorch Dataset과 DataLoader (0) | 2026.09.24 |
| [DeepLearning] PyTorch Tensor 생성 연산과 Shape 변환 (0) | 2026.09.24 |