앞에서는 손글씨 숫자 데이터를 이용해
5인가 / 5가 아닌가
를 판단하는 Binary Classification을 진행했다.
이번 ex13에서는 FashionMNIST 데이터를 이용해 10개의 의류 클래스를 구분하는 Multi-class Classification으로 확장했다.
DataLoader와 Training Loop의 기본 구조는 그대로 사용하면서,
입력 이미지 크기, 모델 출력 개수, Loss Function, 최종 예측값을 만드는 방법
이 이진분류와 어떻게 달라지는지를 확인했다.
⠀
1. FashionMNIST 데이터 불러오기
이번에는 torchvision의 FashionMNIST Dataset을 사용했다.
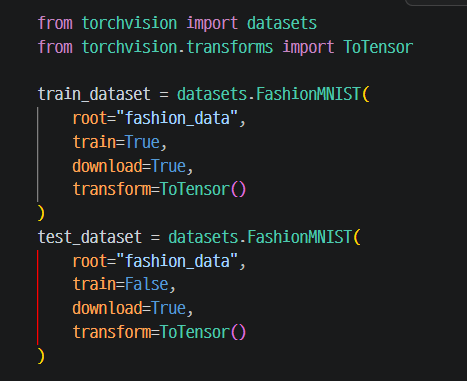
데이터 개수는
Train → 60,000
Test  → 10,000
이었다.
FashionMNIST는 10개의 의류 카테고리를 구분하는 데이터이기 때문에 이번 문제는 이진분류가 아니라 다중분류다.
⠀
2. 이미지 Shape도 달라졌다
데이터 하나를 꺼내 확인하면
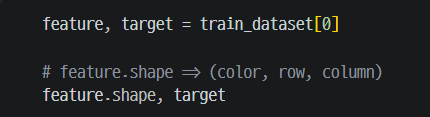
Shape은
(1, 28, 28)형태다.
각 차원의 의미는 다음과 같다.
1  → Channel
28 → Height
28 → Width
즉 하나의 이미지는 28×28 크기의 흑백 이미지다.
앞에서 사용했던 load_digits() 데이터는 8×8 크기였기 때문에
8 × 8 = 64개의 Feature를 사용했다.
하지만 FashionMNIST는
28 × 28 = 784개의 값을 가지게 된다.
⠀
3. DataLoader 사용 방법은 그대로다
Dataset이 바뀌더라도 DataLoader의 사용 방법 자체는 동일하다.
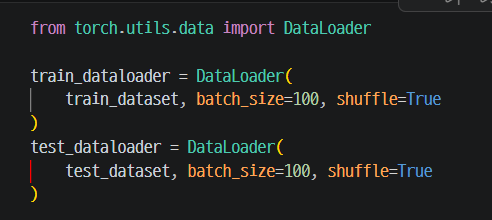
Train 데이터는 60,000개이므로
60,000 / 100
= 600 Batch
Test 데이터는
10,000 / 100
= 100 Batch
가 된다.
한 Batch의 Shape은
features → (100, 1, 28, 28)
targets  → (100,)
이었다.
Dataset이 달라져도
Dataset
↓
DataLoader
↓
Batch
↓
Training Loop
라는 구조 자체는 그대로 유지된다.
⠀
4. MultiModel 구조
이번 실습에서는 새로운 모델 클래스를 처음부터 다시 만드는 것이 아니라,
기존에 사용했던 모델 구조를 확장해 MultiModel을 만들었다.
실제 클래스는 다음과 같이 작성했다.
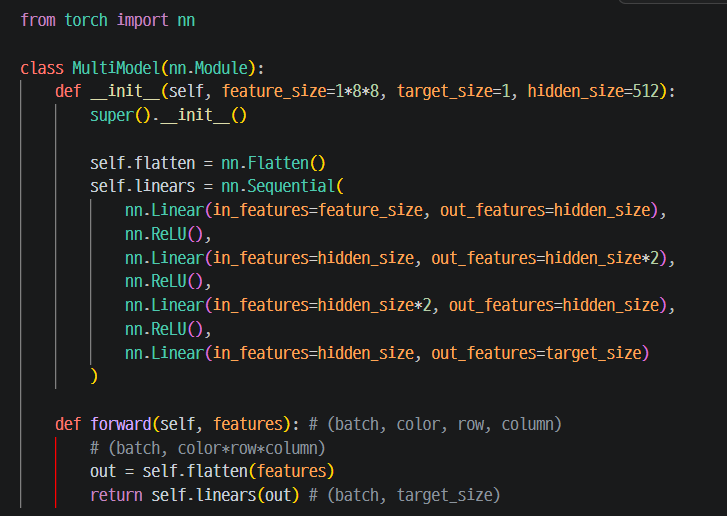
여기서 처음 보면 조금 헷갈릴 수 있는 부분이 있다.
클래스의 기본값은 여전히
feature_size=1*8*8
target_size=1
로 되어 있다.
하지만 이번 FashionMNIST 데이터는 8×8 이미지가 아니라 28×28 이미지이고, 출력 클래스도 1개가 아니라 10개다.
따라서 모델 객체를 만들 때 필요한 값을 직접 전달한다.
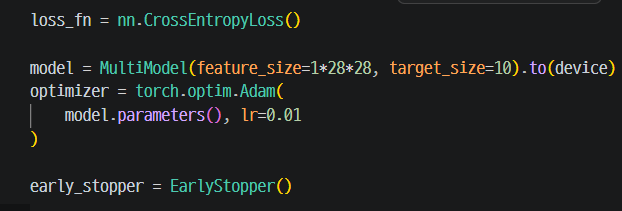
즉 클래스의 기본 구조 자체를 바꾼 것이 아니라,
기본값
feature_size = 1 × 8 × 8
target_size = 1

↓

FashionMNIST 모델 생성 시

feature_size = 1 × 28 × 28
target_size = 10
으로 필요한 값을 덮어쓴 것이다.
⠀
📌 내가 헷갈리기 쉬운 부분
__init__() 안에 작성된 값은 어디까지나 Default 값이다.
feature_size=1*8*8
target_size=1
이라고 적혀 있다고 해서 이 모델이 항상 8×8 입력과 1개의 출력만 사용할 수 있는 것은 아니다.
모델을 생성할 때
MultiModel(
    feature_size=1*28*28,
    target_size=10
)
처럼 새로운 값을 전달하면 해당 값으로 모델이 생성된다.
따라서 같은 MultiModel 구조를 유지하면서도 입력 데이터와 분류 문제에 따라 feature_size와 target_size를 바꿔 사용할 수 있다.
⠀
5. FashionMNIST에서는 왜 feature_size=1×28×28일까?
FashionMNIST 한 장의 Shape은
(1, 28, 28)이다.
모델 내부에서는 가장 먼저
self.flatten = nn.Flatten()을 사용한다.
따라서
(batch, 1, 28, 28)

↓

nn.Flatten()

↓

(batch, 784)
형태로 바뀐다.
즉 첫 번째 Linear Layer가 받아야 하는 입력 Feature 수는
1 × 28 × 28
= 784
다.
그래서 모델을 생성할 때
feature_size=1*28*28을 전달했다.
⠀
6. target_size는 왜 10일까?
이진분류에서는 최종적으로 Logit 하나를 출력했다.
(batch, 1)하지만 FashionMNIST는 총 10개의 클래스를 구분해야 한다.
따라서 하나의 이미지에 대해
Class 0 Logit
Class 1 Logit
Class 2 Logit
...
Class 9 Logit
총 10개의 값을 출력해야 한다.
그래서
target_size=10으로 설정한다.
마지막 Linear Layer는
nn.Linear(
    in_features=hidden_size,
    out_features=target_size
)
이므로 최종 출력 Shape은
(batch, 10)이 된다.
⠀
7. 모델의 전체 Shape 변화
이번 모델의 흐름을 Shape 기준으로 보면 다음과 같다.
FashionMNIST Batch
(batch, 1, 28, 28)

↓

nn.Flatten()

(batch, 784)

↓

Linear
784 → 512

↓

ReLU

↓

Linear
512 → 1024

↓

ReLU

↓

Linear
1024 → 512

↓

ReLU

↓

Final Linear
512 → 10

↓

Logit
(batch, 10)
즉 이미지 하나마다 10개의 Logit을 출력하게 된다.
⠀
8. 이진분류와 Loss Function이 달라진다
앞에서 진행한 Binary Classification에서는
nn.BCEWithLogitsLoss()를 사용했다.
하지만 이번에는 10개의 클래스 중 하나를 고르는 다중분류 문제이기 때문에
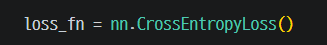
를 사용한다.
정리하면
문제Loss
| 이진분류 | BCEWithLogitsLoss |
| 다중분류 | CrossEntropyLoss |
CrossEntropyLoss()를 사용할 때도 모델 마지막에 Softmax를 붙이지 않고 Logit을 그대로 Loss에 전달한다.
⠀
9. Optimizer는 Adam 사용
이번 실습에서는 Optimizer로 Adam을 사용했다.
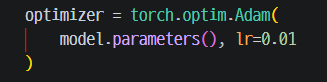
그리고 모델은 GPU에서 학습하도록 Device에 올렸다.
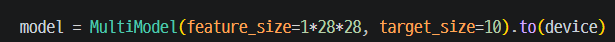
⠀
10. 다중분류에서는 round가 아니라 argmax
이진분류에서는
Logit
↓
Sigmoid
↓
round
↓
0 / 1
을 사용했다.
하지만 다중분류에서는 클래스가 10개이기 때문에 round()로 처리할 수 없다.
먼저 Softmax를 이용해 각 클래스의 확률로 바꾼다.
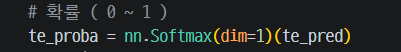
출력 Shape은 그대로
(batch, 10)이다.
그리고 10개 클래스 중 확률이 가장 큰 위치를 선택한다.
te_round = torch.argmax(
    te_proba,
    dim=1
)
예를 들어
[0.01, 0.02, 0.03, 0.80, ...]라면 가장 큰 값이 있는 Class Index를 최종 예측값으로 사용한다.
⠀
11. 왜 Softmax의 dim=1일까?
이번 Logit Shape은
(batch, class)즉
(100, 10)형태다.
0번 차원은 Batch이고,
1번 차원이 10개의 Class다.
따라서 클래스 방향으로 확률을 계산하기 위해
Softmax(dim=1)을 사용한다.
마찬가지로 가장 확률이 높은 클래스를 찾을 때도
argmax(dim=1)을 사용한다.
⠀
📌 내가 헷갈리기 쉬운 부분
dim=1을 무조건 외우는 것보다 현재 Tensor Shape에서
어느 차원이 Class인지
를 먼저 확인하는 것이 중요하다.
⠀
12. 이진분류와 다중분류 비교
구분이진분류다중분류
| 클래스 수 | 2 | 3개 이상 |
| 마지막 출력 | 1 | 클래스 개수 |
| Loss | BCEWithLogitsLoss | CrossEntropyLoss |
| 확률 변환 | Sigmoid | Softmax |
| 최종 Class | round | argmax |
| 출력 Shape | (batch, 1) | (batch, class) |
즉 전체 Training Loop는 크게 달라지지 않는다.
달라지는 것은 문제 유형에 따라 출력과 Loss를 해석하는 방식이다.
⠀
13. Best Model로 최종 평가
ex13에서는 앞에서 만든 EarlyStopper를 그대로 적용했다.
학습이 끝난 후 마지막 모델을 사용하지 않고 저장해둔 Best Model을 다시 불러왔다.

그 다음 Best Model을 이용해 Test 데이터를 예측했다.
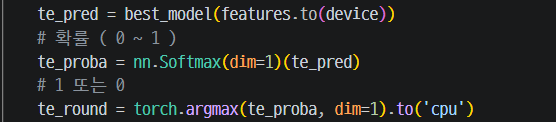
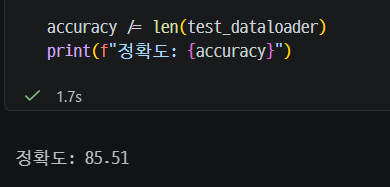
실습 결과에서는 최종 Accuracy가 약 85.51%로 출력됐다.
⠀
14. FashionMNIST도 Confusion Matrix로 평가
다중분류에서도 실제값과 예측값을 모은 뒤 Confusion Matrix를 만들었다.
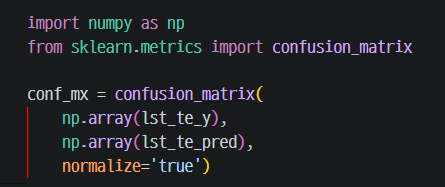
그리고 Heatmap의 x축과 y축에 실제 FashionMNIST 클래스명을 넣었다.
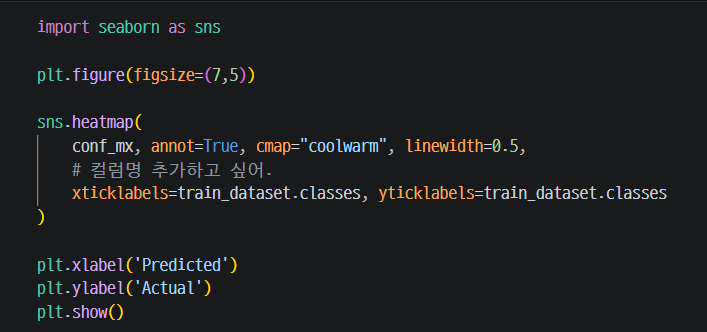
이렇게 하면 단순히
Class 0
Class 1
Class 2
라고 보는 것이 아니라 실제
T-shirt/top
Trouser
Pullover
...
와 같은 클래스 이름을 기준으로 어떤 옷을 어떤 옷으로 많이 잘못 분류했는지 확인할 수 있다.
⠀
15. 핵심 정리
개념기억할 내용
| FashionMNIST | 28×28 흑백 의류 이미지 |
| Train Dataset | 60,000개 |
| Test Dataset | 10,000개 |
| Batch Shape | (batch, 1, 28, 28) |
| Flatten | (batch, 784)로 변경 |
| target_size | 클래스 수인 10 |
| Logit Shape | (batch, 10) |
| CrossEntropyLoss | 다중분류 Loss |
| Softmax | 클래스별 확률로 변환 |
| argmax | 가장 확률이 높은 Class 선택 |
| Early Stopping | 개선되지 않으면 학습 종료 |
| Best Model | 가장 낮은 Test Loss를 기록했을 때 저장한 모델 |
| Confusion Matrix | 클래스별 오분류 패턴 확인 |
이번 실습에서 가장 중요한 흐름은
Binary Classification
↓
Multi-class Classification
으로 문제는 더 복잡해졌지만,
PyTorch의 기본 학습 구조 자체는 거의 바뀌지 않았다는 점이다.
결국 어떤 문제를 풀고 있는지에 따라
Output Size, Loss Function, Probability 변환 방법, 최종 Class 선택 방법
을 맞춰주는 것이 중요하다.