이번 실습의 핵심은
Dataset → DataLoader → Batch → Training Loop
로 이어지는 흐름을 이해하는 것이다.
⠀
1. 손글씨 숫자를 이진분류 문제로 바꾸기
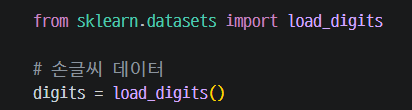
이번 실습에서는 sklearn의 load_digits() 데이터를 사용했다.
load_digits()에는 0부터 9까지의 손글씨 숫자 데이터가 들어 있는데, 이번에는 이 문제를 다중분류가 아니라
"숫자 5인가?"
를 판단하는 이진분류 문제로 바꿨다.
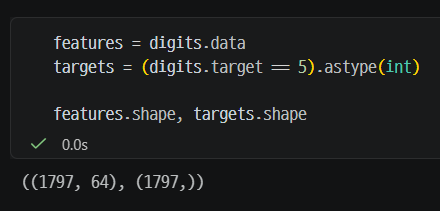
Target이 5라면
15가 아니라면
0으로 변환된다.
즉 기존의
0, 1, 2, 3, 4, 5, 6, 7, 8, 9문제를
5 → 1
나머지 숫자 → 0
인 Binary Classification 문제로 바꾼 것이다.
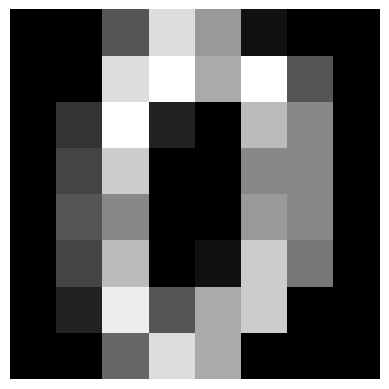
⠀⠀
📌 이번 실습의 포인트
같은 데이터라도 Target을 어떻게 정의하느냐에 따라
- 다중분류
- 이진분류
처럼 서로 다른 문제로 바꿀 수 있다.
⠀
2. Dataset 설명은 짧게, 이번 핵심은 DataLoader
Custom Dataset의 __len__()과 __getitem__() 구조는 28일차에서 이미 다뤘기 때문에 이번 글에서는 반복해서 설명하지 않았다.
새롭게 이어지는 부분은 Dataset을 DataLoader에 연결해 Batch 단위로 데이터를 꺼내는 과정이다.
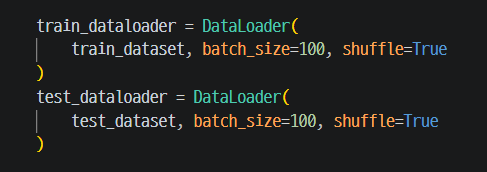
DataLoader는 Dataset을 직접 변경하는 것이 아니라,
Dataset에 저장된 데이터를 여러 개의 Batch로 나누어 반복해서 꺼낼 수 있도록 도와주는 객체라고 보면 된다.
즉 이전에는
Dataset에서 데이터 하나 꺼내기였다면,
이번에는
Dataset에서 데이터 여러 개를 묶어서 Batch로 꺼내기로 확장된 것이다.
⠀
3. Mini-batch로 나누는 이유
이전 실습에서는 Train 데이터 전체를 한 번에 모델에 넣었다.
데이터가 작다면 이런 방식도 가능하지만, 실제 딥러닝에서는 데이터의 개수가 매우 많아질 수 있기 때문에
전체 데이터를 한 번에 메모리에 올리기 어려운 경우가 많다.
그래서 전체 데이터를 작은 묶음인 Mini-batch로 나누어 순차적으로 학습한다.
예를 들어 전체 Train 데이터가 1,000개이고
batch_size=100이라면 한 Epoch 동안 약 10개의 Batch를 학습하게 된다.
전체 구조는 다음과 같다.
Epoch 1
 ├─ Batch 1 → Forward → Loss → Backward → Step
 ├─ Batch 2 → Forward → Loss → Backward → Step
 ├─ Batch 3 → Forward → Loss → Backward → Step
 ...
 └─ 마지막 Batch
여기서 중요한 점은 Optimizer가 Epoch가 끝났을 때 한 번만 파라미터를 업데이트하는 것이 아니라,
각 Batch마다 업데이트된다는 것이다.
즉 Mini-batch Training에서는 한 Epoch 안에서도 모델의 파라미터가 여러 번 변경된다.
⠀⠀
📌 내가 처음 헷갈렸던 부분
처음에는 한 Epoch가 곧 한 번의 Parameter Update라고 생각하기 쉬운데,
DataLoader를 사용하면
1 Epoch
=
여러 Batch 반복
=
여러 번의 Parameter Update
가 된다.
⠀
4. batch_size는 한 번에 꺼낼 데이터 개수
이번 실습의 Train 데이터는 1,347개였다.
batch_size=100이므로
100개
100개
...
100개
마지막 47개
처럼 총 14개의 Batch가 만들어진다.
⠀
5. shuffle=True는 왜 사용하는가
이번 DataLoader에서는
shuffle=True를 사용했다.
이 옵션을 사용하면 Epoch가 시작될 때 데이터의 순서를 섞어서 Batch를 구성한다.
Train 데이터가 항상 같은 순서로 들어가는 것보다, 매 Epoch마다 서로 다른 샘플 조합으로 Batch가 만들어질 수 있기 때문에
특정 데이터 순서에 지나치게 영향을 받는 것을 줄이는 데 도움이 된다.
즉
Epoch 1
[1, 2, 3, 4, 5 ...]

Epoch 2
[53, 12, 84, 7, 21 ...]
처럼 데이터의 순서가 달라질 수 있다.
⠀⠀
📌 Train과 Test의 차이
Train 데이터는 학습을 위해 섞는 경우가 많지만,
Test 데이터는 파라미터를 업데이트하는 용도가 아니기 때문에 일반적으로 반드시 섞을 필요는 없다.
이번 실습에서는 Test DataLoader에도 shuffle=True를 사용했지만, 평가 자체를 위해 꼭 필요한 옵션은 아니다.
⠀
6. DataLoader에서 한 Batch 직접 꺼내보기
DataLoader가 실제로 어떤 데이터를 반환하는지 확인하기 위해 iter()와 next()를 사용할 수 있다.
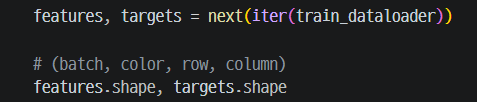
이번 실습에서 실제 출력 Shape은 다음과 같았다.
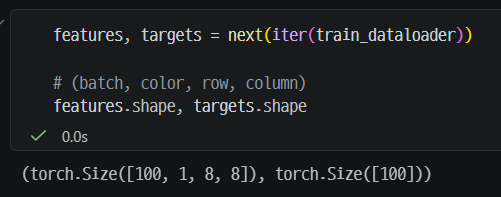
처음 load_digits()에서
features = digits.data를 사용했을 때 원본 데이터는 이미지 한 장당 64개의 값으로 펼쳐진
(1797, 64)형태였다.
하지만 이번 Custom Dataset의 __getitem__()에서는 데이터를 꺼낼 때
return feature.reshape(1, 8, 8), target을 사용했다.
따라서 하나의 데이터는
(64,)
↓
(1, 8, 8)
형태로 다시 바뀌고,
DataLoader가 100개를 하나의 Batch로 묶으면
(100, 1, 8, 8)형태가 된다.
즉 각 차원의 의미는 다음과 같다.
100 → Batch Size
1   → Channel
8   → Height
8   → Width
그리고 이후 모델 내부의 nn.Flatten()을 통과하면서
(100, 1, 8, 8)
↓
(100, 64)
로 바뀐 뒤 Linear Layer에 입력된다.
⠀
📌 내가 헷갈리기 쉬운 부분
digits.data 자체는 이미 (데이터 수, 64) 형태로 Flatten되어 있지만, 이번 Dataset에서 다시 (1, 8, 8)로 reshape했기 때문에 DataLoader가 반환하는 Tensor는 이미지 형태다.
그리고 모델 내부의 Flatten()에서 다시 64개의 Feature로 펼쳐진다.
즉 이번 코드의 실제 흐름은
digits.data
(1797, 64)

↓

Dataset.__getitem__()
(1, 8, 8)

↓

DataLoader
(batch, 1, 8, 8)

↓

nn.Flatten()
(batch, 64)

↓

Linear Layer
로 이해하면 된다.
⠀
7. 전체 데이터를 한 번에 넣는 코드에서 Batch 반복문으로 바뀐다
이전 실습에서는 전체 Train 데이터를 모델에 한 번에 넣었다.
예를 들어
tr_pred = model(x_tr)처럼 사용했다.
하지만 DataLoader를 사용하면 Epoch 안에서 DataLoader를 다시 반복해야 한다.
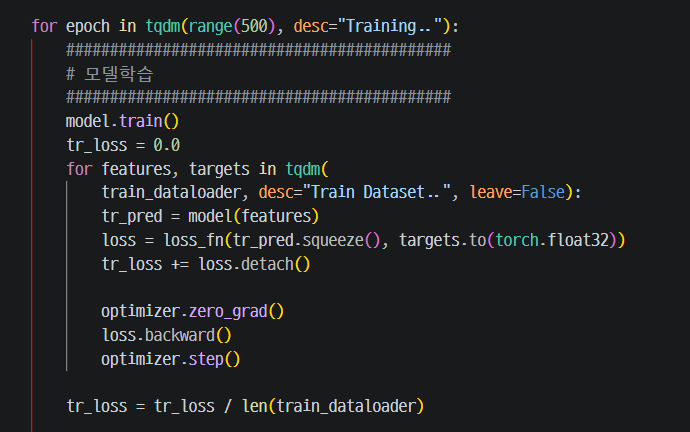
즉 구조가
Epoch 반복에서
Epoch 반복
    ↓
Batch 반복
으로 한 단계 더 들어간다.
⠀⠀
📌 변화 포인트
Training Loop의 기본 순서는 그대로다.
Forward
↓
Loss
↓
zero_grad
↓
backward
↓
step
다만 이 과정이 한 Epoch에 한 번 실행되는 것이 아니라, 각 Batch마다 반복된다.
⠀
8. targets를 float32로 바꾸는 이유
이번 실습에서도 Loss Function으로
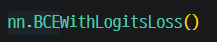
를 사용했다.
Target은 처음에
0
1
형태의 정수값으로 만들어졌지만, BCEWithLogitsLoss()에서는 Target을 실수형 Tensor로 사용하는 것이 필요하다.
그래서
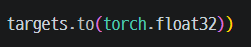
를 사용했다.

즉
Target
0, 1
이라는 클래스 값 자체는 그대로 유지하면서 Tensor의 dtype만
int → float32로 바꾼 것이다.
⠀
9. 왜 loss.detach()를 사용할까?
Batch별 Loss를 누적하기 위해 다음과 같이 작성했다.
tr_loss += loss.detach()여기서 detach()는 Loss Tensor를 Gradient 계산 그래프에서 분리하는 역할을 한다.
학습을 위해 필요한 Loss는
loss.backward()를 통해 Gradient를 계산해야 하지만,
tr_loss에 누적하는 값은 단순히
- 출력
- 기록
- 평균 계산
용도로 사용하는 값이다.
따라서 이 값까지 계속 Gradient 계산 그래프에 연결해둘 필요가 없다.
즉
loss는 역전파에 사용하고,
loss.detach()는 기록용 값으로 사용한다고 생각하면 이해하기 쉽다.
⠀⠀
📌 기억할 점
detach()를 했다고 원래 loss 자체의 Gradient 계산이 사라지는 것은 아니다.
별도로 분리된 값만 Gradient 계산 대상에서 제외된다.
⠀
10. Batch Loss를 왜 평균내는가
Training Loop에서는 각 Batch마다 Loss가 하나씩 계산된다.
그래서 먼저 각 Batch에서 계산된 Loss를 누적한다.
tr_loss += loss.detach()그리고 Epoch가 끝난 뒤
tr_loss = tr_loss / len(train_dataloader)로 나누어 Batch Loss의 평균을 계산했다.
여기서 len(train_dataloader)는 데이터 개수가 아니라 DataLoader가 가지고 있는 Batch의 개수다.
이번 실습의 Train DataLoader는 총 14개의 Batch로 구성되어 있기 때문에, 14개의 Batch에서 계산된 Loss를 평균내는 방식이다.
⠀
📌 기억할 점
이 방식은 Batch별 평균 Loss의 평균이다.
마지막 Batch처럼 Batch 크기가 서로 다른 경우까지 데이터 개수 기준으로 정확하게 평균내려면 각 Batch의 샘플 수까지 반영하는 방법을 사용할 수 있지만, 이번 실습에서는 DataLoader 단위의 평균 Loss를 확인하는 방식으로 진행했다.
⠀
11. Test 데이터도 Batch 단위로 평가한다
Train 데이터만 Batch로 나누는 것이 아니라 Test 데이터도 DataLoader를 통해 Batch 단위로 평가한다.
model.eval()

te_loss = 0.0

with torch.inference_mode():

    for features, targets in test_dataloader:

        te_pred = model(features)

        loss = loss_fn(
            te_pred.squeeze(),
            targets.to(torch.float32)
        )

        te_loss += loss.detach()

te_loss = te_loss / len(test_dataloader)
학습 단계와 구조는 비슷하지만 큰 차이가 있다.
Train에서는
optimizer.zero_grad()
loss.backward()
optimizer.step()
을 실행하지만,
Test에서는 모델의 파라미터를 업데이트할 필요가 없다.
따라서
model.eval()과
torch.inference_mode()를 사용해 평가만 수행한다.
⠀
12. Train과 Test Loop 비교
두 과정을 비교하면 차이를 더 쉽게 볼 수 있다.
구분TrainTest
| model.train() | 사용 | X |
| model.eval() | X | 사용 |
| Forward | O | O |
| Loss 계산 | O | O |
| zero_grad | O | X |
| backward | O | X |
| optimizer.step | O | X |
| inference_mode | X | O |
즉 Test 단계에서도 Forward와 Loss 계산은 하지만,
Gradient 계산
Parameter Update
는 하지 않는다.
⠀
13. Batch별 Accuracy도 계산한다
평가 단계에서는 Loss뿐만 아니라 Accuracy도 계산했다.
이진분류이기 때문에 모델의 출력값은 먼저 Logit이다.
따라서 이전 ex11에서 했던 것처럼
Logit
↓
Sigmoid
↓
Probability
↓
round
↓
0 / 1
순서로 변환한다.
model.eval()

accuracy = 0.0

with torch.inference_mode():

    for features, targets in test_dataloader:

        te_pred = model(features)

        te_proba = torch.sigmoid(te_pred)

        te_round = torch.round(te_proba)

        accuracy += accuracy_fn(
            y_true=targets,
            y_pred=te_round.squeeze()
        )

accuracy /= len(test_dataloader)
즉 각 Batch마다 Accuracy를 계산한 뒤 전체 DataLoader의 Batch 개수로 나누어 평균 Accuracy를 구했다.
⠀
14. squeeze()는 여기서도 필요하다
이전 이진분류 실습과 마찬가지로 모델의 예측 결과 Shape은
(batch, 1)형태가 될 수 있다.
하지만 Target은
(batch,)형태다.
따라서 Accuracy를 계산하기 전에
te_round.squeeze()를 사용해 Shape을 맞췄다.
즉 ex11에서 배운
Logit → Sigmoid → round → squeeze
흐름이 이번 DataLoader 실습에서도 그대로 이어졌다.
이번 실습은 완전히 새로운 내용을 배우는 것이라기보다,
이전에 배운
- Binary Classification
- BCEWithLogitsLoss
- Sigmoid
- squeeze
- Training Loop
에
DataLoader와 Mini-batch
를 추가한 것이라고 볼 수 있다.
⠀
15. Dataset → DataLoader → Training Loop 흐름
이번 실습을 전체적으로 정리하면 다음과 같다.
load_digits 데이터
↓
'5인가 아닌가' Target 생성
↓
Train / Test 분리
↓
Custom Dataset 생성
↓
DataLoader 연결
↓
Mini-batch 생성
↓
Epoch 시작
↓
Batch 반복
↓
Forward
↓
Loss
↓
Backward
↓
Optimizer Step
↓
다음 Batch
↓
Epoch Loss 평균 계산
↓
Test DataLoader 평가
28일차에서는 Dataset을 만드는 것 자체가 중심이었다면,
이번에는 그 Dataset이 실제 모델 학습 과정에서 어떻게 반복적으로 사용되는지까지 이어진 것이 핵심이었다.
⠀
16. 전체 데이터를 한 번에 학습하는 것과의 차이
기존 방식은 다음과 같다.
전체 Train Data
↓
Model
↓
Loss
↓
Backward
↓
Step
반면 Mini-batch Training은
Train Data
↓
Batch 1 → 학습
Batch 2 → 학습
Batch 3 → 학습
...
처럼 진행된다.
즉 전체 데이터를 한 번에 처리하지 않고 여러 번 나누어 모델에 전달한다.
이 구조를 이해하고 나면 이후 이미지 데이터나 더 큰 Dataset을 사용할 때 등장하는 DataLoader 코드도 훨씬 이해하기 쉬워진다.
⠀
17. 핵심 정리
개념기억할 내용
| Dataset | 개별 데이터를 꺼낼 수 있도록 구성 |
| DataLoader | Dataset을 Batch 단위로 반복 가능하게 연결 |
| batch_size=100 | 한 번에 최대 100개 샘플을 꺼내 사용 |
| Mini-batch | 전체 데이터를 작은 묶음으로 나눈 것 |
| Mini-batch Training | Epoch 안에서 Batch별로 Forward / Backward / Step 수행 |
| shuffle=True | Epoch마다 데이터 순서를 섞어 Batch 구성 |
| load_digits Shape | digits.data 사용 시 하나의 이미지는 64개 Feature |
| detach() | 기록용 Loss를 Gradient 계산 그래프에서 분리 |
| 평균 Loss | Batch Loss를 누적한 뒤 Batch 개수로 나눔 |
| squeeze() | (batch, 1)을 (batch,)로 맞출 때 사용 |
이번 파트에서 가장 중요한 내용을 한 문장으로 정리하면,
DataLoader를 사용하면 전체 데이터를 한 번에 학습하는 대신, 여러 개의 Mini-batch로 나누어 한 Epoch 안에서 Forward → Loss → Backward → Step을 반복할 수 있다.
그리고 이번 실습을 통해 Dataset이 단순히 데이터를 저장하는 객체로 끝나는 것이 아니라,
Dataset → DataLoader → Mini-batch → Training Loop
로 실제 모델 학습까지 연결되는 흐름을 확인할 수 있었다.