1. 데이터 시각화가 필요한 이유
데이터가 많아지면 사람이 원본을 눈으로 모두 해석할 수 없다. 이때 통계 함수와 시각화를 사용한다. 하지만 평균·분산·표준편차가 같아도 실제 데이터의 모양은 전혀 다를 수 있으므로, 통계값만 보고 분석을 끝내면 위험하다.
1-1. 앤스컴의 4분할 그래프
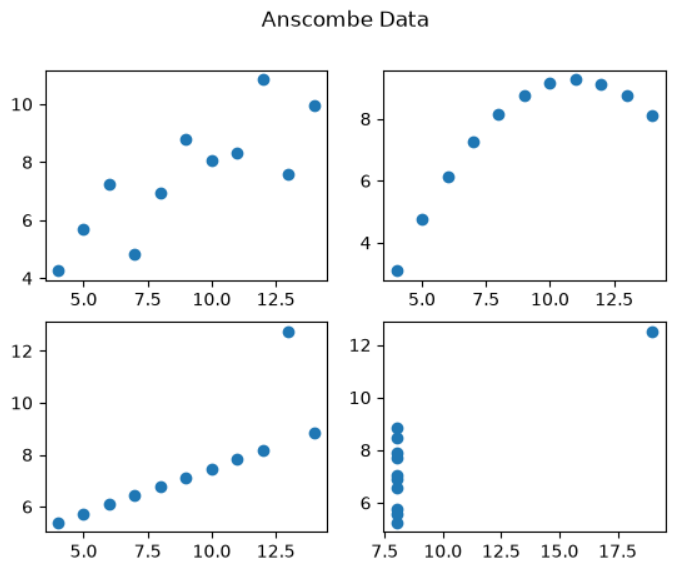
앤스컴의 네 데이터셋은 평균, 분산, 상관계수 등 주요 통계값이 거의 같지만 산점도로 그리면 분포와 이상치가 완전히 다르게 보인다. 이는 ‘통계가 틀렸다’는 뜻이 아니라, 요약 통계만으로는 데이터의 구조를 충분히 설명할 수 없다는 뜻이다.
| 데이터 분석은 통계 + 시각화를 기본 세트로 진행한다. 특히 머신러닝·딥러닝에서는 분포와 이상치가 전처리 및 모델 선택에 직접 영향을 준다. |
2. 그래프를 그리기 전에 확인할 것
| 확인 항목 | 확인 방법 | 이유 |
| 행·열 수 | df.shape | 데이터 규모와 피처 수를 파악 |
| 결측치 | df.info(), df.isna().sum() | 그래프 왜곡과 전처리 필요 여부 확인 |
| 자료형 | df.info(), df.dtypes | 수치형·범주형에 따라 그래프가 달라짐 |
| 기초 통계 | df.describe() | 범위·중심·산포를 먼저 파악 |
| 샘플 | df.head(), df.tail() | 컬럼의 실제 값과 형태를 확인 |
| 그래프 읽기 순서 : 제목보다 먼저 x축과 y축이 무엇을 의미하는지 확인하고, 범례·색상·단위·분포·이상치를 차례로 본다. |
3. Seaborn과 Matplotlib의 관계
Seaborn은 Matplotlib을 기반으로 동작한다. Seaborn은 적은 코드로도 보기 좋은 기본 결과를 만들기 쉽고, Matplotlib은 세부 요소를 자유롭게 조정할 때 유리하다. 그림은 한 번에 완성되는 것이 아니라 배경, 축, 데이터, 범례처럼 레이어가 차례로 쌓인다고 이해하면 쉽다.
| 밥 로스의 오일 페인팅처럼 큰 배경부터 만들고 세부 요소를 덧붙인다. 프로젝트도 최소 구조를 먼저 만든 뒤 기능과 디테일을 단계적으로 추가하는 편이 안정적이다. |
4. 목적별 그래프 선택 기준
| 분석 목적 | 주요 데이터 | 대표 함수 | 해석 포인트 |
| 관계 | 수치형 x + 수치형 y | sns.relplot() | 두 변수의 추세·패턴·상관 |
| 분포 | 수치형 1개 이상 | sns.histplot(), sns.kdeplot() | 값이 어디에 몰렸는지 |
| 범주 비교 | 범주형 x + 수치형 y | sns.catplot() | 그룹별 크기·분포 차이 |
| 이상치 | 범주형 x + 수치형 y | sns.boxplot() / catplot(kind='box') | 중앙값·IQR·이상치 |
5. 관계형 그래프 : relplot
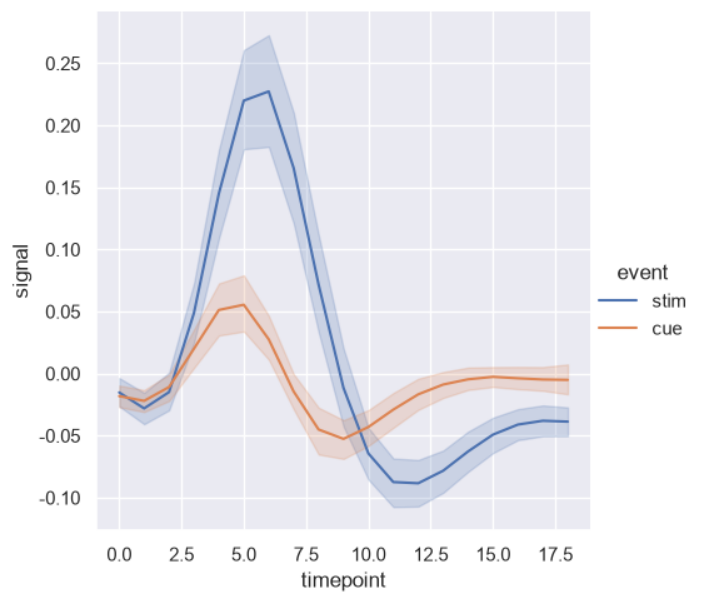
| fmri = sns.load_dataset("fmri") sns.relplot( data=fmri, kind="line", x="timepoint", y="signal", hue="event" ) |
- x, y: 관계를 비교하므로 기본적으로 수치형 데이터
- hue, style: 색·선 모양으로 그룹을 나누므로 범주형 데이터
- col, row: 그래프 자체를 여러 칸으로 분할하므로 범주형 데이터
- Jupyter에서 마지막 출력 문구가 거슬리면 그래프 함수 끝에 세미콜론(;)을 붙일 수 있다.
6. 분포형 그래프
6-1. 히스토그램
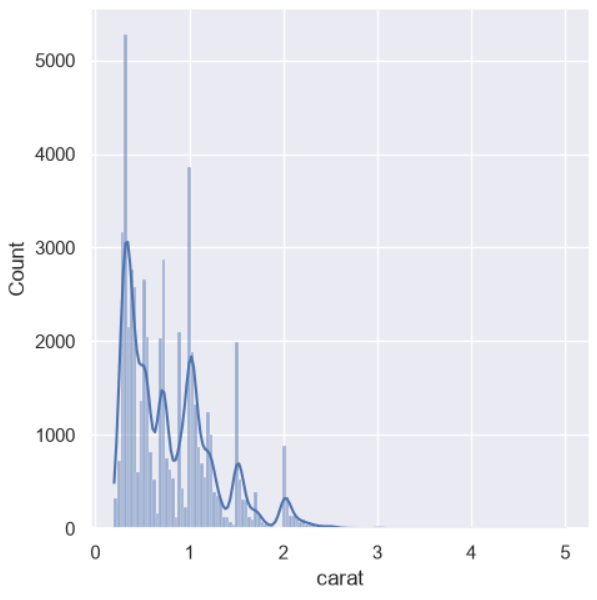
| penguins = sns.load_dataset("penguins") sns.displot(penguins, x="flipper_length_mm", bins=20) sns.displot( penguins, x="flipper_length_mm", hue="species", multiple="stack" ) |
| 히스토그램 | 막대그래프 |
| x축이 연속적인 수치형 데이터 | x축이 범주형 데이터 |
| 막대가 붙어 있으며 구간이 이어짐 | 범주 사이가 분리되어 막대가 떨어짐 |
| bins로 구간 개수를 바꿀 수 있음 | 범주 개수에 따라 막대 수가 정해짐 |
막대 모양이 비슷해도 데이터 유형과 질문이 다르다. 연봉 구간, 길이, 나이처럼 연속적인 값의 분포를 볼 때는 히스토그램을 사용한다.
6-2. KDE(확률밀도)와 2차원 분포
| sns.displot( penguins, x="flipper_length_mm", hue="species", kind="kde", fill=True ) sns.displot( penguins, x="bill_length_mm", y="bill_depth_mm", kind="kde", thresh=.2, levels=4 ) |
KDE는 값이 어느 구간에서 나타날 가능성이 높은지 부드러운 곡선으로 표현한다. 2차원 KDE는 히트맵이나 등고선처럼 두 변수의 밀집 구간을 보여준다. 확률밀도 그래프의 y값 자체보다 곡선 아래 전체 면적이 1이라는 점에 주의한다.
7. 범주형 그래프와 점 겹침

| sns.catplot(data=tips, x="day", y="total_bill") sns.catplot( data=tips, x="day", y="total_bill", kind="swarm" ) |
기본 점 그래프에서 같은 위치의 점이 겹치면 실제 관측치 수를 알기 어렵다. swarm 형태는 점을 옆으로 벌려 겹침을 줄이므로 데이터가 얼마나 몰렸는지 더 정확히 볼 수 있다. 데이터가 매우 많으면 swarm은 느리거나 복잡해질 수 있어 stripplot의 jitter나 box/violin plot을 고려한다.
'개발 공부 > 데이터 분석' 카테고리의 다른 글
| [데이터 분석] 데이터 클렌징 시작하기 | 결측치 확인·삭제·대체·검증 (0) | 2026.09.03 |
|---|---|
| [데이터 분석] Titanic 변수 관계 분석 | 교차표·피벗테이블·상관관계 (0) | 2026.09.03 |
| [데이터 분석] 분포와 이상치 분석 | 왜도·첨도·로그 변환 이해하기 (0) | 2026.09.02 |
| [데이터 분석] EDA 시작하기 | Titanic 구조 확인 (1) | 2026.09.02 |
| [Pandas] Iris와 Titanic 데이터로 데이터 분석 연습 (0) | 2026.08.31 |