| 글의 핵심 범주형 데이터는 교차표와 피벗테이블로, 수치형 데이터는 산점도와 상관계수로 관계를 읽는 방법을 정리한다. |
모든 변수 관계를 같은 방식으로 분석할 수는 없다. 성별이나 객실 등급처럼 범주형인 변수는 그룹별 개수와 비율을 비교하고, 나이·요금처럼 수치형인 변수는 산점도와 상관관계로 함께 움직이는 정도를 확인한다.
1. mode(): 범주형 데이터의 최빈값 구하기
df_object['who'].mode()
df_object['who'].mode()[0]
mode()는 가장 많이 나온 값, 즉 최빈값을 반환한다. 최빈값이 여러 개일 수도 있어 결과를 Series 형태로 돌려준다.
Titanic의 who에서는 man 하나만 최빈값이므로 mode()[0]은 첫 번째 최빈값인 man을 꺼낸다.
df_object['who'].mode().values[0]
values는 값만 배열로 가져오는 속성이고 [0]은 첫 번째 위치다.
mode() 결과가 ['man'] 하나뿐이면 values[1]은 두 번째 값이 없어서 IndexError가 발생한다.
2. pd.crosstab(): 두 범주형 변수의 개수 비교
pd.crosstab(
index=df['sex'],
columns=df['survived'],
margins=True
)
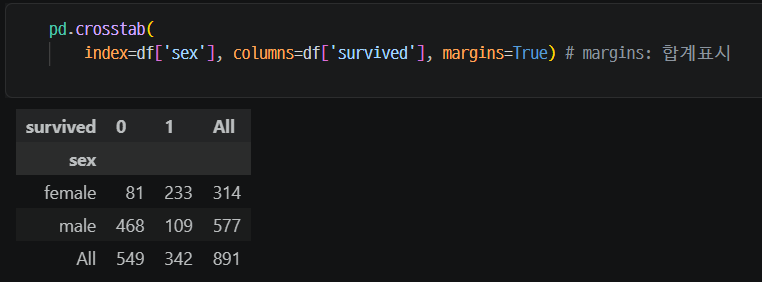
| 성별 | 사망(0) | 생존(1) | 합계 |
| female | 81 | 233 | 314 |
| male | 468 | 109 | 577 |
| All | 549 | 342 | 891 |
여성 314명 중 233명이 생존했고, 남성 577명 중 109명이 생존했다.
단순 개수만으로는 집단 크기가 달라 비교하기 어려울 수 있으므로, 비율도 함께 확인하는 것이 좋다.
3. normalize 옵션: 전체 비율·열 비율·행 비율
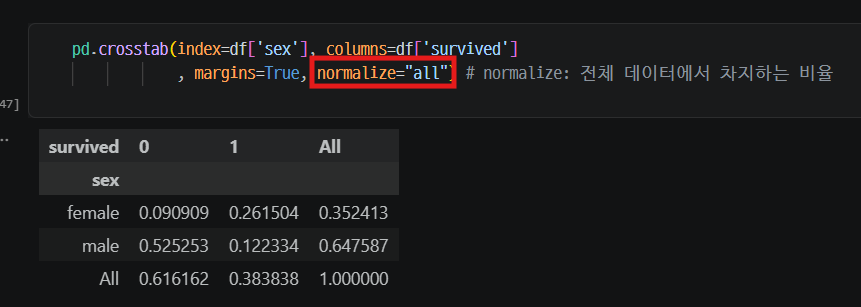
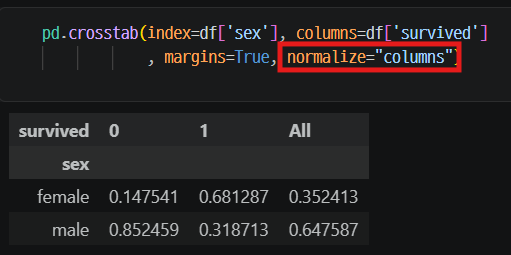
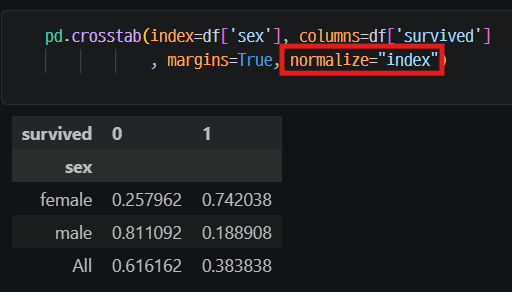
| 코드 | 분모 | 질문 | 예시 해석 |
| normalize="all" | 전체 891명 | 전체 중 어떤 조합이 얼마나 차지할까? | 생존 여성 0.2615 = 전체의 26.15% |
| normalize="columns" | 각 생존 열 | 사망자·생존자 안에서 성별 비율은? | 사망자 중 남성 약 85.2% |
| normalize="index" | 각 성별 행 | 여성·남성 각각의 생존률은? | 여성 중 생존 약 74.2% |
pd.crosstab(df['sex'], df['survived'], normalize='index')
normalize="columns"에서는 각 열의 합이 이미 1이므로, 아래 All 행이 정보량 없는 1이 되어 표시되지 않을 수 있다.
반대로 오른쪽 All 열은 전체 성별 비율이므로 남아 있다.
4. pivot_table(): 그룹별 통계를 한 번에 보기
df_pivot = pd.pivot_table(
df,
index='pclass',
columns='sex',
values='survived',
aggfunc=['mean', 'sum']
)
df_pivot
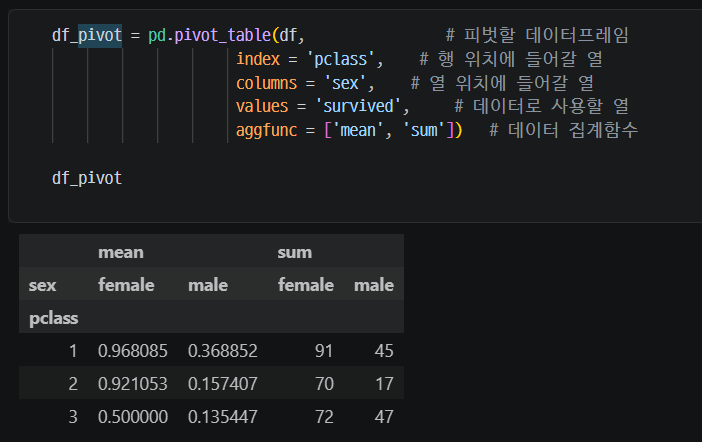
survived는 사망=0, 생존=1이므로 평균(mean)은 생존율이고 합계(sum)는 생존자 수다.
| 객실 등급 | 여성 생존율 | 남성 생존율 | 여성 생존자 | 남성 생존자 |
| 1등석 | 96.8% | 36.9% | 91명 | 45명 |
| 2등석 | 92.1% | 15.7% | 70명 | 17명 |
| 3등석 | 50.0% | 13.5% | 72명 | 47명 |
표를 보면 성별뿐 아니라 객실 등급도 생존과 관련된 패턴이 있다는 점을 알 수 있다. 특히 3등석 여성의 생존율은 1·2등석 여성보다 낮다.
5. corr(): 수치형 변수끼리의 선형 관계
df_number = df.select_dtypes(include=np.number)
df_number.corr()
| 상관계수 | 의미 |
| 1 | 완벽한 양의 선형 관계: 함께 증가 |
| -1 | 완벽한 음의 선형 관계: 하나가 증가하면 다른 하나는 감소 |
| 0 부근 | 뚜렷한 선형 관계가 약함 |
-0.3은 완전히 관계가 없다는 뜻보다는 약한 음의 상관 또는 실무적으로 크지 않은 관계에 가깝다. 그리고 상관관계는 원인과 결과를 증명하지 않으며, 곡선 같은 비선형 관계는 상관계수가 낮아도 존재할 수 있다.
6. 산점도로 숫자 관계를 눈으로 확인하기
df_number.plot(kind='scatter', x='fare', y='age')
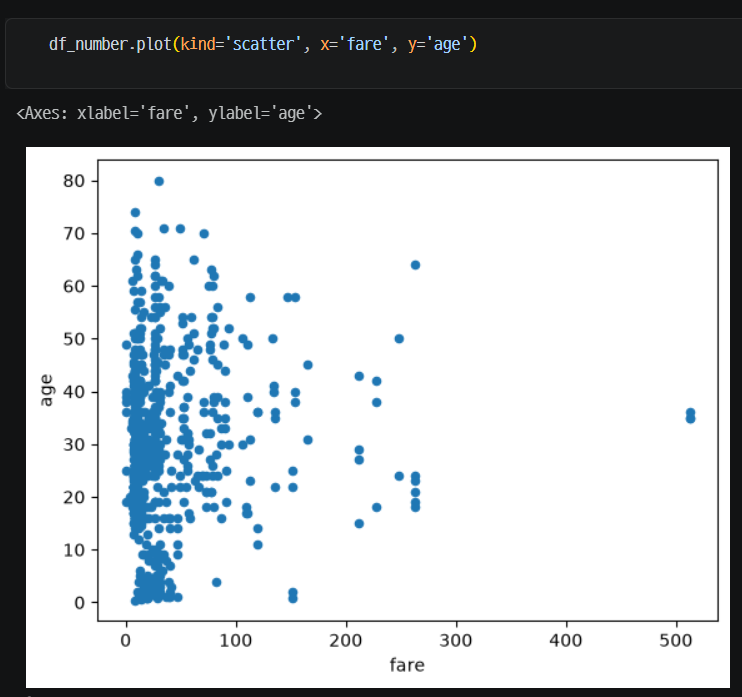
kind는 그래프의 종류를 지정하는 옵션이다. scatter는 산점도이며, 점이 오른쪽 위로 길게 모이면 양의 상관, 오른쪽 아래로 모이면 음의 상관, 사방으로 퍼지면 상관이 낮다고 본다.
fare와 age 산점도는 요금이 같아도 나이가 넓게 퍼져 있어, 요금만으로 나이를 예측하기 어렵다.
반면 pclass와 fare는 1등석에서 높은 요금이 많이 나타나고 3등석으로 갈수록 낮은 요금이 많은 경향이 보여 음의 상관관계가 나타난다.
df_number.plot(kind='scatter', x='pclass', y='fare')
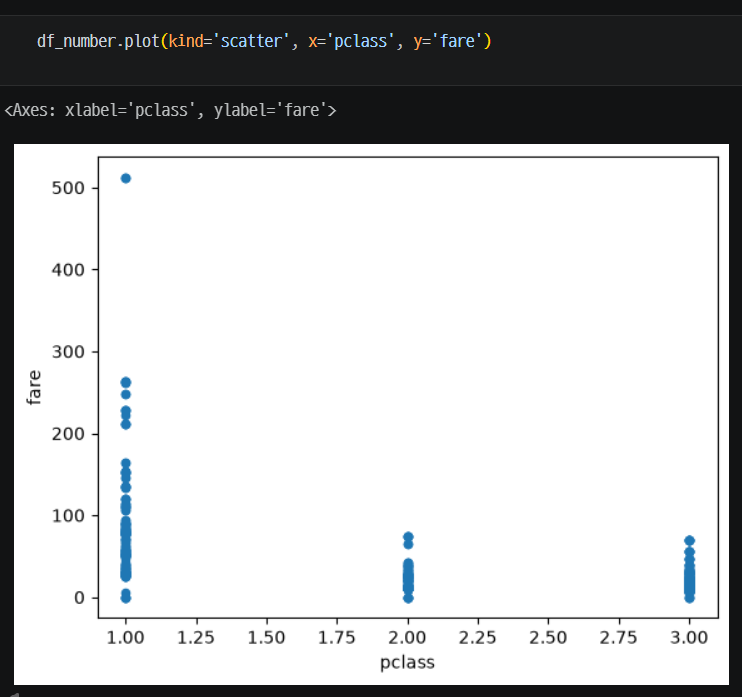
| 주의 pclass는 1·2·3으로 기록되지만 연속형 숫자가 아닌 순서형 범주 데이터다. 이 경우 산점도와 상관계수는 보조적으로 보고, 등급별 요금 분포는 boxplot으로 함께 확인하는 편이 더 자연스럽다. |
7. heatmap으로 상관관계 한 번에 보기
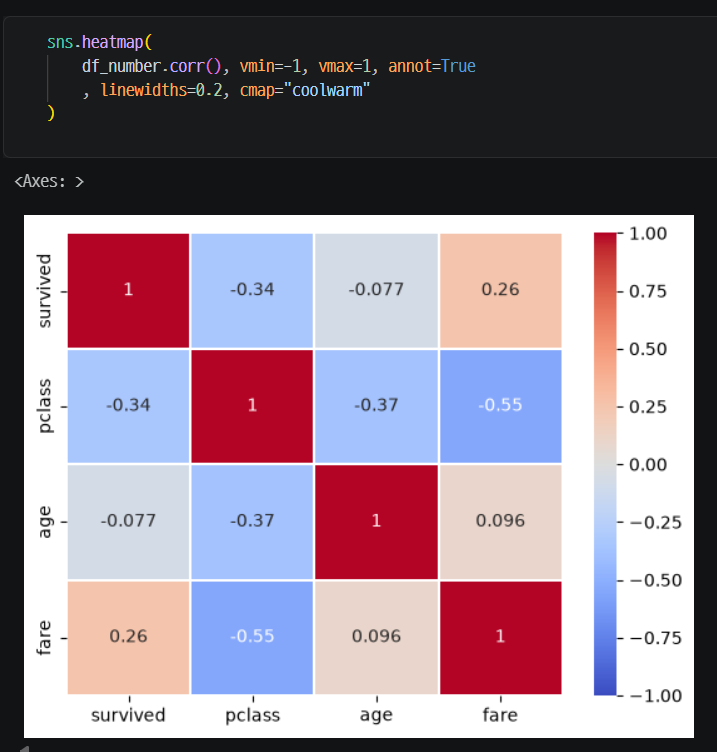
sns.heatmap(
df_number.corr(),
vmin=-1, vmax=1, annot=True,
linewidths=0.2, cmap='coolwarm'
)
| 옵션 | 역할 |
| df_number.corr() | 숫자형 컬럼 사이 상관계수 표를 계산한다. |
| vmin=-1, vmax=1 | 색상 기준을 -1~1로 고정해 그래프끼리 비교하기 쉽게 한다. |
| annot=True | 각 칸 안에 상관계수 숫자를 표시한다. |
| linewidths=0.2 | 칸 사이 선을 얇게 넣는다. |
| cmap="coolwarm" | 음수는 파랑, 양수는 빨강, 0 부근은 흰색 계열로 표현한다. |
히트맵에서는 타겟 survived와 피처의 관계를 먼저 보고, 다음으로 피처끼리 지나치게 비슷한 정보를 갖는지 확인한다. fare와 fare_log처럼 같은 정보를 변환한 컬럼은 동시에 넣을 필요가 없는 경우가 많다.
| 마무리 범주형 변수는 교차표·막대그래프·피벗테이블로, 수치형 변수는 산점도·상관계수·히트맵으로 확인한다. 단, 숫자로 저장된 pclass처럼 실제 의미가 범주형인 변수는 해석을 조심해야 한다. |
'개발 공부 > 데이터 분석' 카테고리의 다른 글
| [Machine Learning] 범주형 데이터 인코딩과 학습·테스트 전처리 (0) | 2026.09.03 |
|---|---|
| [Machine Learning] 전체 워크플로우와 유방암 데이터 탐색하기 (0) | 2026.09.03 |
| [Machine Learning] 분포와 이상치 분석 | 왜도·첨도·로그 변환 이해하기 (0) | 2026.09.02 |
| [Machine Learning] EDA 시작하기 | Titanic 구조 확인 (1) | 2026.09.02 |
| [Machine Learning] Seaborn 데이터 시각화 기초 (0) | 2026.09.01 |


