선형회귀에서는 각 Feature에 Weight를 곱해 Target을 예측한다.
하지만 학습 데이터에 지나치게 맞춰지면 새로운 데이터에서는 성능이 떨어질 수 있다.
이번에는 기본 LinearRegression과 Weight에 제약을 주는 Ridge, Lasso, ElasticNet의 차이를 정리해봤다.
⠀⠀⠀
1. 단순 선형회귀와 다중 선형회귀
Feature가 하나라면 단순 선형회귀로 표현할 수 있다.
y = wx + b
실제 데이터에서는 여러 Feature가 Target에 동시에 영향을 주는 경우가 많다.
이때는 다중 선형회귀로 확장할 수 있다.
y = w₁x₁ + w₂x₂ + ... + wₙxₙ + b
Feature가 늘어나면 각 Feature에 대응하는 Weight도 함께 늘어난다.
x₁에는 w₁, x₂에는 w₂처럼 각각의 Feature에 하나의 Weight가 연결된다.
⠀⠀⠀
2. Weight는 무엇을 의미할까?
선형모델에서는 각 Feature에 Weight가 곱해져 예측값에 반영된다.
Weight가 0이면 해당 Feature를 곱한 값도 0이 되므로 그 Feature는 예측에 반영되지 않는다.
같은 스케일의 Feature끼리 비교한다면 Weight의 절댓값이 클수록 해당 Feature의 변화가 예측값에 더 크게 반영된다고 볼 수 있다. 반대로 Weight가 0에 가까워질수록 예측값에 미치는 영향도 작아진다.
📌 Weight의 부호는 영향의 방향을 나타낸다.
+이면 Feature가 증가할 때 예측값이 증가하는 방향, -이면 감소하는 방향으로 작용한다.
⠀⠀⠀
3. 왜 Regularization이 필요할까?
LinearRegression은 학습 데이터의 오차를 줄이는 방향으로 각 Weight를 결정한다.
그런데 모델이 학습 데이터에 지나치게 맞춰지면 Train에서는 성능이 높지만 Test에서는 성능이 크게 떨어지는 Overfitting(과적합)이 나타날 수 있다.
Regularization(규제)은 기존 오차뿐 아니라 Weight의 크기에도 제약을 추가해 모델이 지나치게 복잡해지는 것을 억제하는 방법이다.
📌 Regularization의 목적은 Train 점수를 무조건 높이는 것이 아니라,
과적합을 줄여 새로운 데이터에서도 안정적으로 예측할 수 있도록 일반화 성능을 높이는 것이다.
⠀⠀⠀
4. L1과 L2 Regularization
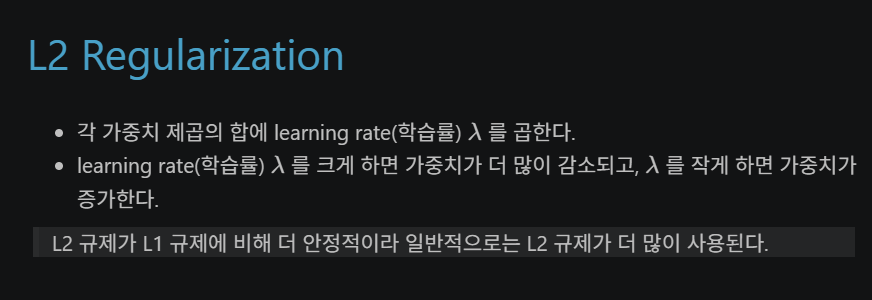
Weight에 어떤 방식으로 패널티를 주는지에 따라 대표적으로 L1과 L2 규제로 나눌 수 있다.
| 구분 | L1 Regularization | L2 Regularization |
| 대표 모델 | Lasso | Ridge |
| 규제 방식 | Weight 절댓값의 합에 패널티 | Weight 제곱의 합에 패널티 |
| Weight 특징 | 일부 계수가 정확히 0이 될 수 있음 | 계수를 작게 만들지만 일반적으로 0이 되지는 않음 |
| 특징 | 일부 Feature를 제외하는 효과 | 여러 Feature의 계수를 전체적으로 축소 |
⠀⠀⠀
L1은 일부 Weight를 0으로 만들 수 있기 때문에 Feature selection과 비슷한 효과를 낼 수 있다.
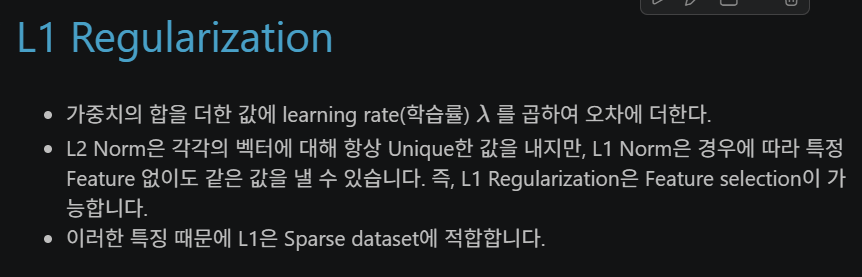
L2는 특정 Weight를 완전히 제거하기보다는 여러 Weight의 크기를 줄이는 방향으로 규제한다. ⠀
⠀⠀⠀
5. LinearRegression - 규제가 없는 기본 선형회귀
from sklearn.linear_model import LinearRegression
lr = LinearRegression()
lr.fit(X_tr, y_tr)
pred = lr.predict(X_te)
`fit()`으로 Train 데이터를 학습한 뒤 `predict()`로 새로운 데이터의 값을 예측한다.
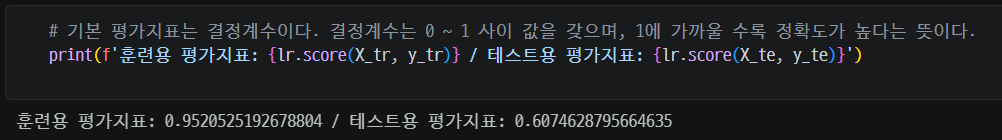
또한 Train score와 Test score를 비교하면 모델이 학습 데이터에만 지나치게 맞춰졌는지 확인하는 데 도움이 된다.
예제에서는 Train 점수가 0.95보다 높게 나타난 반면 Test 점수는 약 0.61 수준으로 차이가 크게 나타난다.
이처럼 Train 성능은 매우 높은데 Test 성능이 상대적으로 낮다면 과적합을 의심할 수 있다.

⠀⠀⠀
6. Ridge - L2 Regularization
Ridge는 L2 규제를 적용한 선형회귀 모델이다.
Weight의 제곱에 패널티를 주어 계수의 크기가 지나치게 커지는 것을 억제한다.
from sklearn.linear_model import Ridge
ridge = Ridge().fit(X_tr, y_tr)
ridge10 = Ridge(alpha=10).fit(X_tr, y_tr)
print(ridge10.score(X_tr, y_tr), ridge10.score(X_te, y_te))
Ridge에서 `alpha`는 규제 강도를 조절하는 하이퍼파라미터이다.
alpha가 커질수록 규제가 강해져 Weight의 크기가 작아지는 경향이 있다.
| alpha | 의미 |
| 작음 | 규제가 약함 → LinearRegression에 가까워짐 |
| 큼 | 규제가 강함 → Weight를 더 작게 제한 |
규제가 너무 약하면 과적합을 충분히 줄이지 못할 수 있고,
반대로 너무 강하면 필요한 관계까지 제한해 Underfitting(과소적합)이 나타날 수 있다.
따라서 Train/Test 성능을 비교하면서 적절한 alpha를 찾는 것이 중요하다.
📌 alpha는 Learning Rate가 아니다.
Learning Rate는 파라미터 업데이트 크기를 조절하고, Ridge/Lasso의 alpha는 규제의 강도를 조절한다.
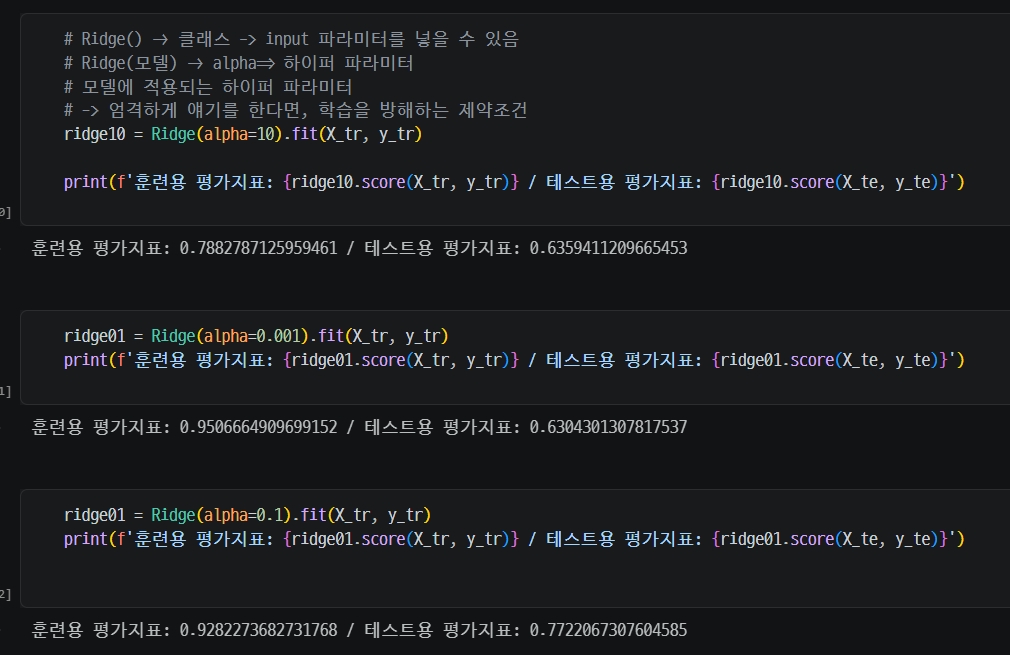
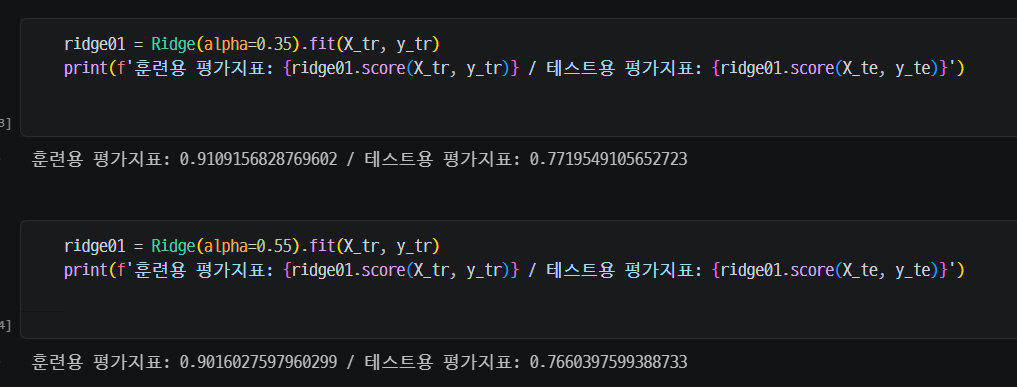
alpha 값을 바꾸면 규제 강도가 달라지고, 그에 따라 Train/Test 성능도 함께 변한다.
예제에서는 alpha가 너무 작거나 너무 클 때보다 중간 수준의 alpha에서 Test 성능이 더 높게 나타나는 구간을 확인할 수 있다.
따라서 alpha는 단순히 크게 설정하는 것이 아니라, Train/Test 성능을 비교하면서 적절한 값을 찾는 것이 중요하다.
⠀⠀⠀
7. Ridge의 계수 그래프로 alpha 변화 확인하기
각 Feature의 `coef_`를 그래프로 비교하면 alpha가 Weight에 어떤 영향을 주는지 더 쉽게 확인할 수 있다.
규제가 없는 LinearRegression을 기준으로 Ridge의 alpha를 크게 할수록 여러 계수가 0에 가까운 방향으로 축소된다.
다만 Ridge는 Lasso와 달리 일반적으로 계수를 정확히 0으로 만들지는 않는다. 따라서 Feature 자체를 제거하기보다는 각 Feature의 영향이 지나치게 커지지 않도록 조절하는 방식에 가깝다.
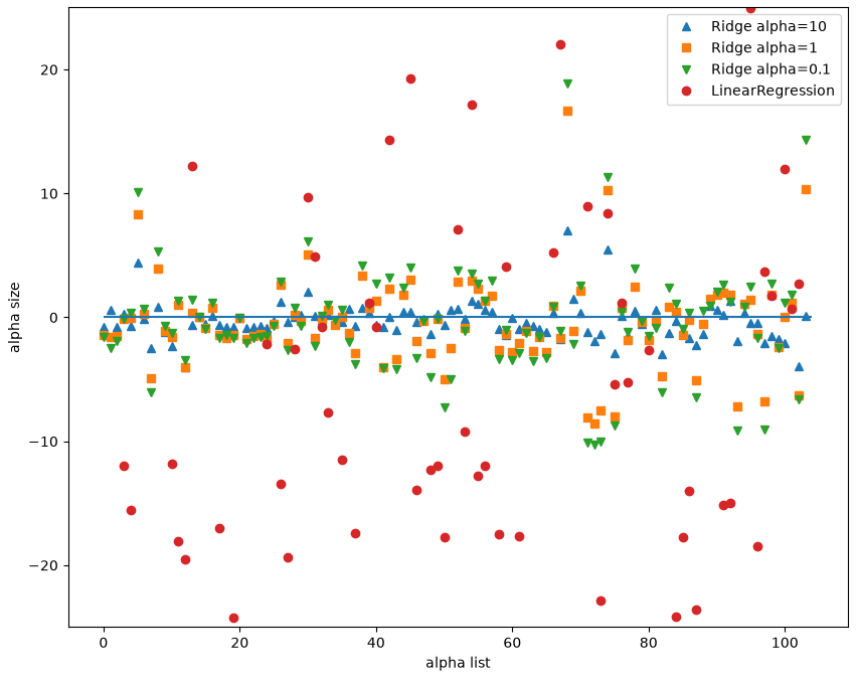
규제가 없는 LinearRegression과 비교하면 Ridge의 alpha가 커질수록 각 Feature의 계수 크기가 0에 가까워지는 것을 확인할 수 있다.
즉, alpha가 커질수록 규제가 강해지면서 Weight의 크기를 더 강하게 제한한다.
다만 Ridge는 Lasso와 달리 Weight를 작게 만들 뿐, 일반적으로 정확히 0으로 만들지는 않는다.
⠀⠀⠀
8. Lasso - L1 Regularization
Lasso는 L1 규제를 사용하는 선형회귀 모델이다.
L1 규제의 특징은 일부 Weight를 정확히 0으로 만들 수 있다는 점이다.
from sklearn.linear_model import Lasso
lasso = Lasso().fit(X_tr, y_tr)
print(np.sum(lasso.coef_ != 0))
lass001 = Lasso(alpha=0.01, max_iter=100000).fit(X_tr, y_tr)
`np.sum(lasso.coef_ != 0)`은 Lasso 학습 후 계수가 0이 아닌 Feature가 몇 개인지 확인하는 코드이다.
계수가 0이 된 Feature는 예측식에서 사실상 제외되기 때문에 Lasso는 Feature selection 효과를 가질 수 있다.
Lasso 역시 alpha가 커질수록 규제가 강해지며 더 많은 계수가 0이 될 수 있다.
반대로 alpha를 너무 작게 하면 규제 효과가 약해진다.
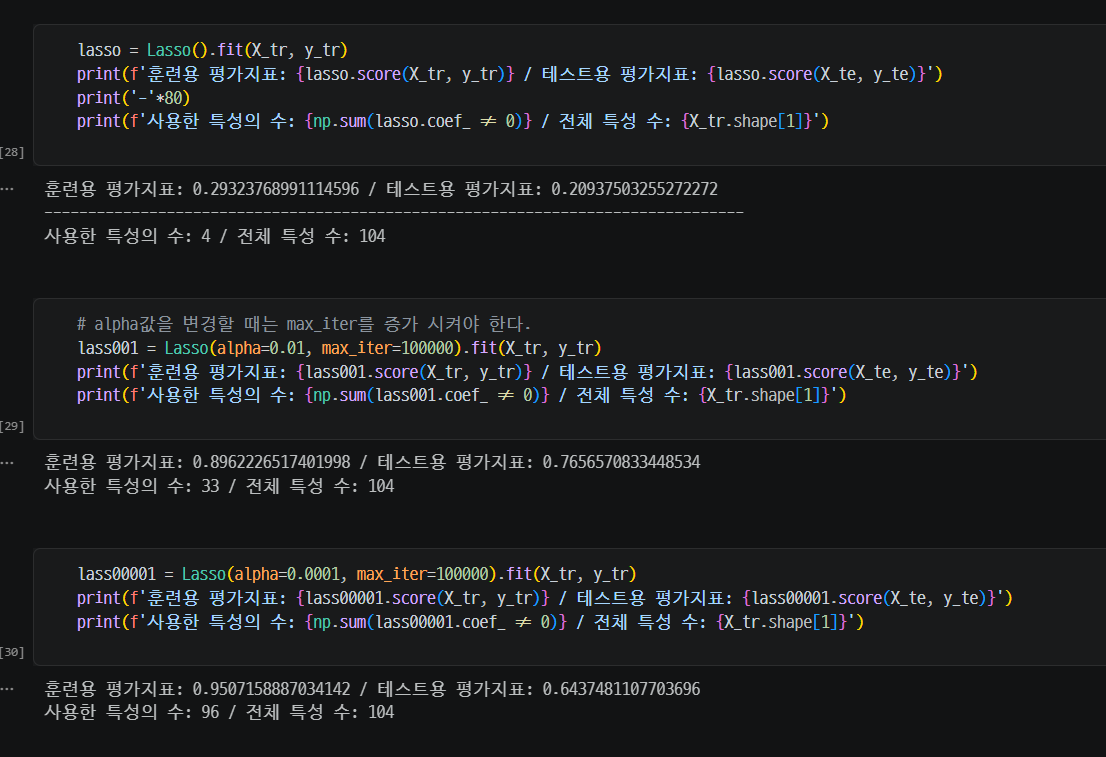
기본 Lasso에서는 104개의 Feature 중 4개만 사용했지만, alpha=0.01로 규제를 약하게 설정하자 33개의 Feature를 사용하는 것으로 증가했다.
즉, Lasso는 alpha 값에 따라 일부 Weight를 0으로 만들 수 있으며, alpha가 작아질수록 규제가 약해져 더 많은 Feature가 예측에 사용될 수 있다.
⠀⠀⠀
9. ElasticNet - L1과 L2를 함께 사용
ElasticNet은 L1과 L2 규제를 함께 사용하는 모델이다.
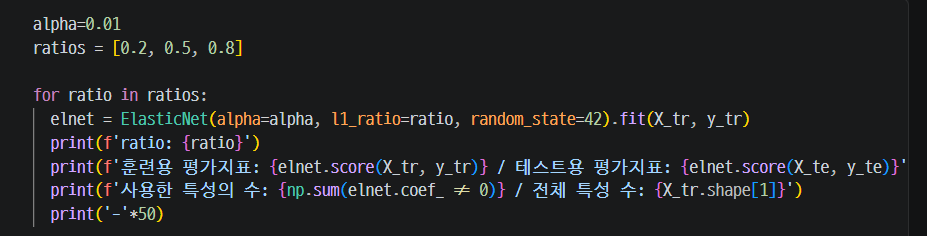
전체 규제 강도는 `alpha`, L1과 L2의 비율은 `l1_ratio`로 조절한다.
from sklearn.linear_model import ElasticNet
elnet = ElasticNet(
alpha=0.01,
l1_ratio=0.8,
random_state=42
).fit(X_tr, y_tr)
| 파라미터 | 의미 |
| alpha | 전체 규제 강도 |
| l1_ratio = 0 | L2 규제만 사용 |
| l1_ratio = 1 | L1 규제만 사용 |
| 0 < l1_ratio < 1 | L1 + L2 혼합 |
예를 들어 l1_ratio=0.8이면 L1의 비중 80%, L2 규제 비중이 20%인 형태로 규제를 혼합한다.
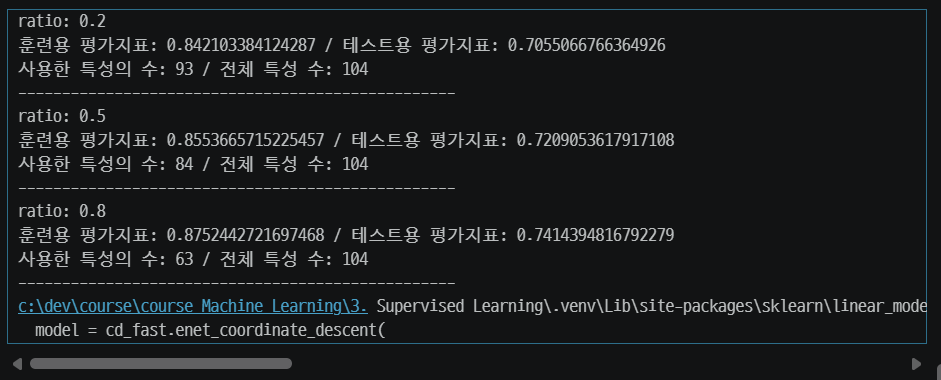
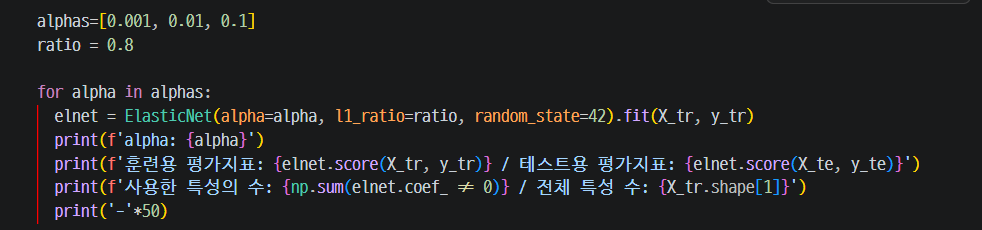
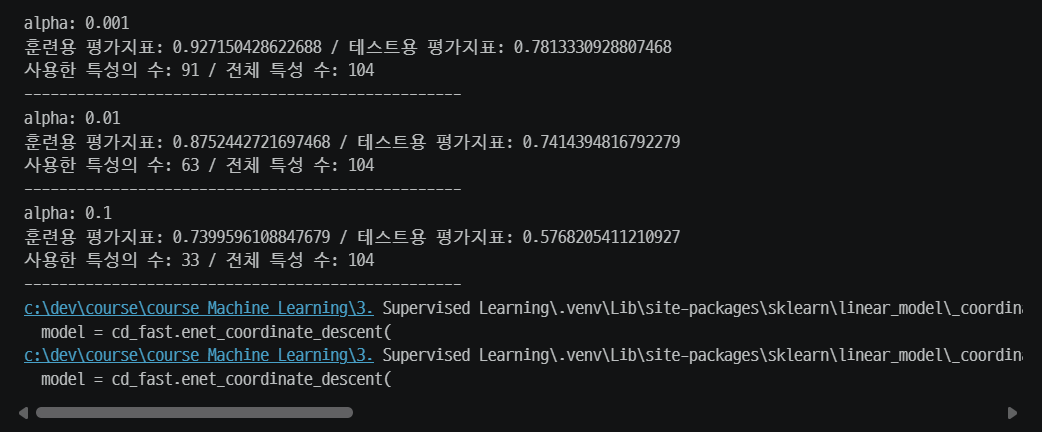
예제에서는 l1_ratio를 0.2, 0.5, 0.8로 바꾸거나 alpha를 0.001, 0.01, 0.1로 바꾸면서 성능 변화를 비교한다.
⠀⠀⠀
10. LinearRegression / Ridge / Lasso / ElasticNet 정리
| 모델 | 규제 | 특징 |
| LinearRegression | 없음 | 기본 선형회귀 |
| Ridge | L2 | Weight를 전체적으로 작게 조절 |
| Lasso | L1 | 일부 Weight가 0이 될 수 있음 |
| ElasticNet | L1 + L2 | 두 규제를 함께 사용 |
규제가 너무 약하면 과적합을 충분히 억제하지 못할 수 있고, 너무 강하면 모델이 데이터의 관계를 충분히 학습하지 못할 수 있다.
따라서 단순히 Train 점수가 높은 모델을 선택하는 것이 아니라, Test 또는 Validation 데이터에서도 안정적인 성능을 보이는 규제 방법과 alpha 값을 선택하는 것이 중요하다.