1. 왜 Scaling이 필요할까?
수치형 feature는 서로 값의 범위가 크게 다를 수 있다.
예를 들어 Titanic 데이터에서 Pclass는 1~3 정도이지만, Age는 수십, Fare는 수백까지 커질 수 있다.
하지만 숫자가 크다고 해서 해당 feature가 더 중요한 것은 아니다.
따라서 특정 feature에 과도한 영향을 받지 않도록,
데이터의 크기와 범위를 비슷한 기준으로 맞춰주는 과정이 필요하다.
⠀
2. 스케일링도 Train에서 기준을 학습한다
인코딩에서 정리한 원리와 동일하다.
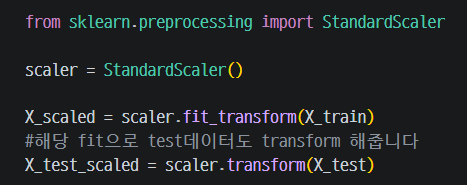
Train에서 스케일링 기준을 학습하고 Test에는 그 기준을 그대로 적용한다.
⠀
3. 다양한 Scaling 방법
Scaling에는 StandardScaler와 MinMaxScaler 외에도 Normalizer, PowerTransformer, QuantileTransformer, RobustScaler, MaxAbsScaler 등 다양한 방법이 있다.
각각 데이터를 조정하는 기준과 특징이 다르기 때문에, 데이터의 특성에 따라 적절한 방법을 선택할 수 있다.
이번에는 StandardScaler와 MinMaxScaler를 중심으로 살펴보고, 나머지 방법은 특징만 간단하게 정리한다.
| 방법 | 특징 |
| Normalizer | 각 행의 크기를 기준으로 값을 정규화. 일반적인 표형 데이터의 feature scling에는 자주 사용하지 않는다. |
| PowerTransformer | 데이터 분포를 정규분포에 가깝게 변환. |
| QuantileTransformer | 분위수 기준으로 데이터를 균등/정규분포 형태로 변환. |
| RobustScaler | 중앙값과 IQR 기준으로 스케일링. 이상치의 영향을 비교적 적게 받는다. |
| MaxAbsScaler | 각 feature의 최대 절댓값을 기준으로 값을 조정. |
⠀
4. StandardScaler⭐ (가장 먼저 고려하는 방법)
StandardScaler는 각 feature의 값을 평균 0, 표준편차 1이 되도록 변환하는 방법이다.
feature마다 값의 범위가 다르더라도 비슷한 기준으로 비교할 수 있도록 스케일을 맞춰 준다.
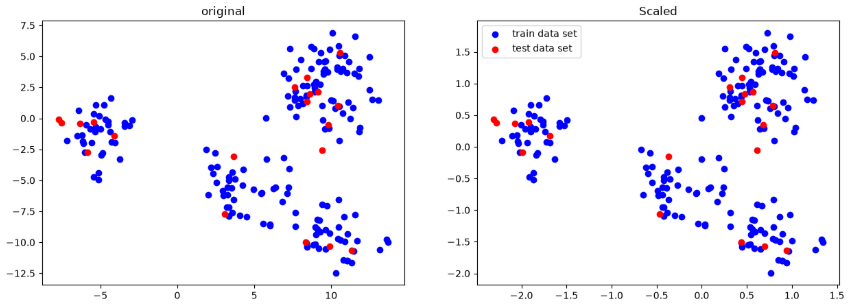
다만 평균과 표준편차를 기준으로 계산하기 때문에,
극단적으로 큰 값이나 작은 값과 같은 이상치가 많으면 Scaling 결과에 영향을 받을 수 있다.
⠀
5. MinMaxScaler⭐
MinMaxScaler는 각 feature의 값을 일반적으로 0~1 범위로 변환하는 방법이다.
최솟값을 0, 최댓값을 1로 맞추고, 그 사이의 값들도 원래 값의 크기 차이를 유지하면서 0~1 사이로 줄여준다.
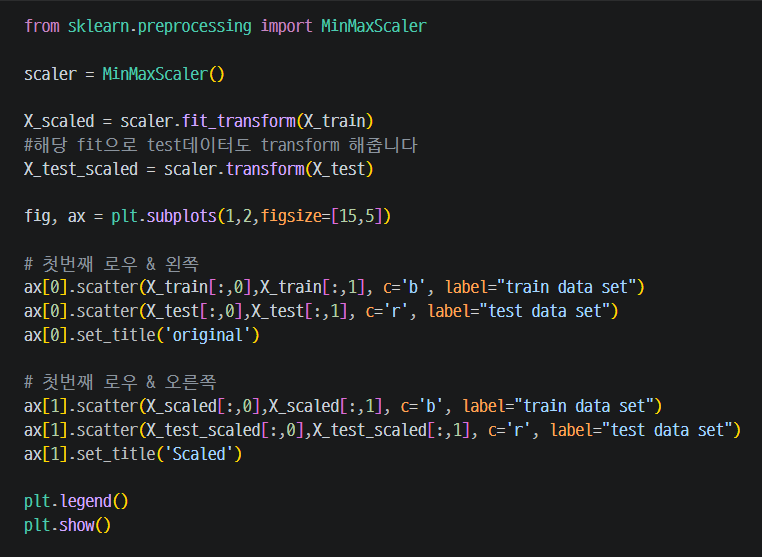
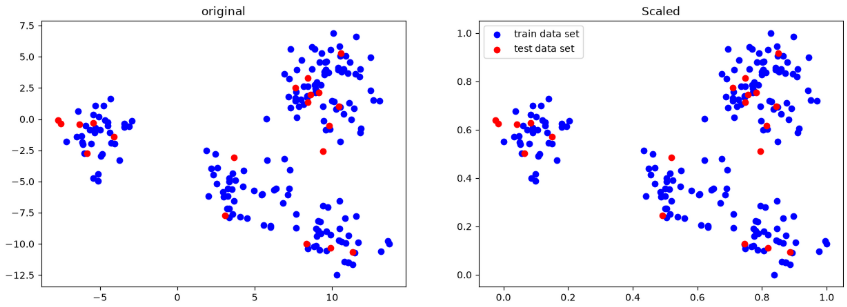
모든 값을 일정한 범위 안으로 맞출 수 있다는 장점이 있지만,
최솟값과 최댓값을 기준으로 계산하기 때문에 이상치가 있으면 Scaling 결과가 크게 영향을 받을 수 있다. ⠀
두 Scaler의 차이
- StandardScaler : 평균과 표준편차를 기준으로 변환
- MinMaxScaler : 최솟값과 최댓값을 기준으로 일정 범위로 변환
⠀
6. Transformer와 Scaler를 함께 쓸 때
Transformer는 데이터의 분포 형태를 바꾸는 역할을 하고, Scaler는 값의 크기나 범위를 조정하는 역할을 한다.
둘을 함께 사용할 경우, Transformer를 분포를 먼저 변환하고, Scaler를 적용하는 순서로 사용할 수 있다.
원본 데이터 -> Transformer -> Scaler
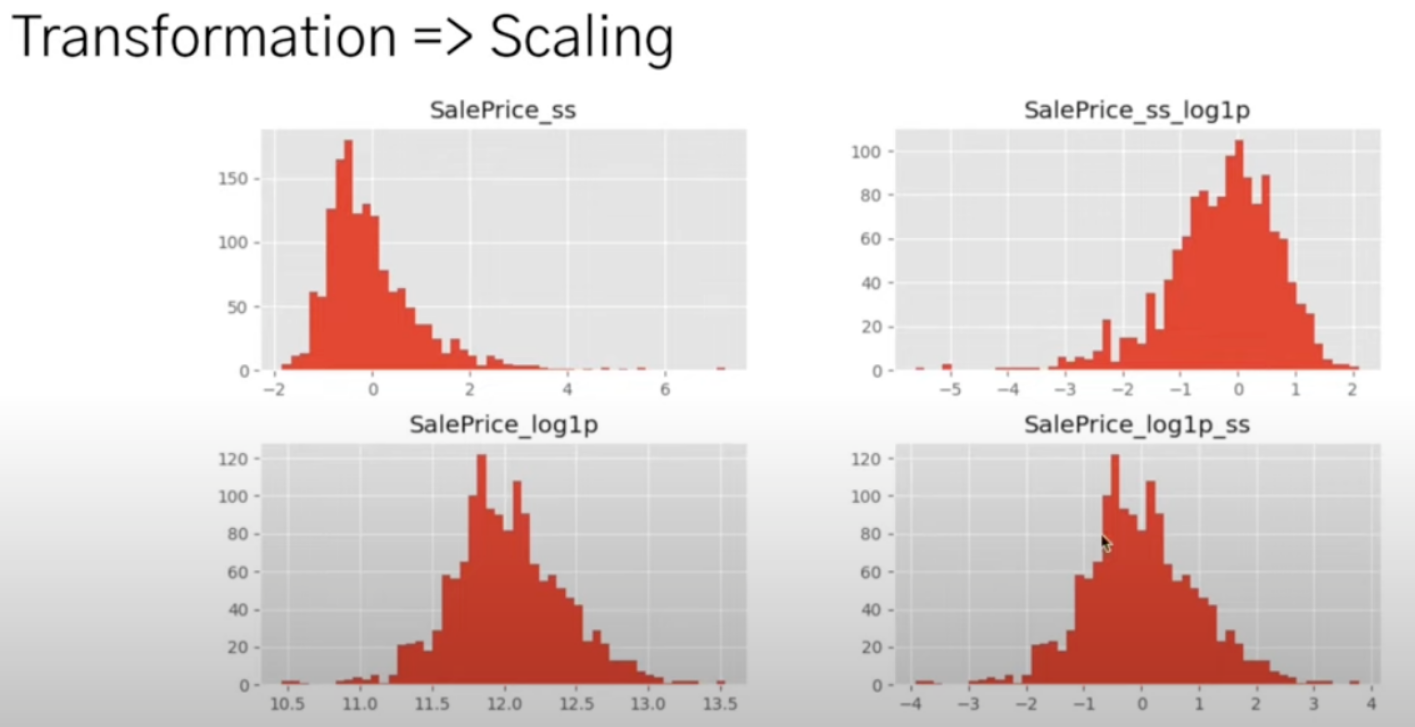
- Scaler 적용 -> Transformer 적용 (단점)
(SalePrice_ss -> SalePrice_ss_log1p)
변환 전후의 분포 형태가 달라지는 것을 확인할 수 있다. - Transformer 적용, Scaler 적용 (장점)
(SalePrice_log1p -> SalePrice_log1p_ss)
변환 전후의 분포 형태가 비슷하게 유지되는 것을 확인할 수 있다.
⠀
7. StandardScaler를 ScalingType으로 관리
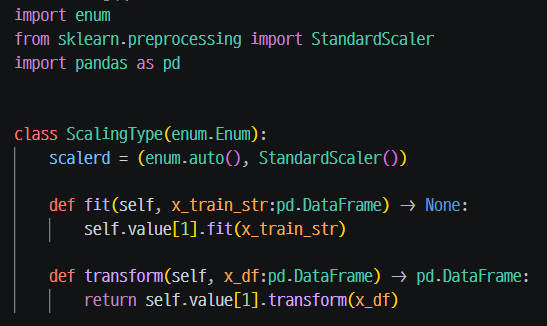
common/scaling.py에서는 StandardScaler 객체를 ScalingType Enum으로 관리한다.
앞에서 사용한 EncodingType과 동일한 설계 패턴으로, 사용할 Scaler 객체를 한곳에서 관리할 수 있도록 구성한 것이다.
⠀
8. transform_scaling()
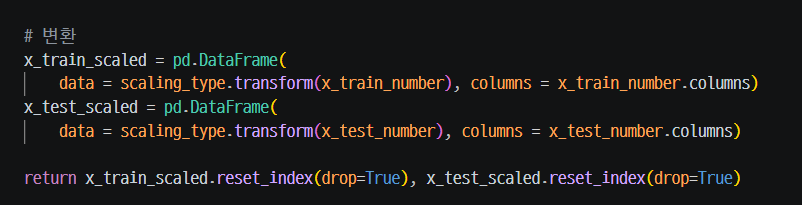
transform_scaling()은 앞에서 정리한 transform_encoding()과 전체적인 구조가 비슷하다.
다만 스케일링 결과를 처리하는 과정에서 DataFrame으로 다시 변환하고, index를 초기화하는 과정이 추가된다.
⠀
8-1. transform 결과 => DataFrame으로 다시 만드는 이유
Scaler는 숫자 데이터를 변환하는 도구이기 때문에, transform() 결과를 NumPy 배열 형태로 반환한다.
따라서 transform()을 거치면 DataFrame에 있던 컬럼명 정보가 사라진다.
그래서 pd.DataFrame()으로 다시 변환하면서 columns에 원래 컬럼명을 지정해 기존 컬럼명을 다시 붙여준다.
⠀
8-2. reset_index(drop=True)
인코딩 결과와 스케일링 결과를 axis=1로 concat()할 때, 두 데이터의 인덱스가 서로 다르면 행이 제대로 맞지 않아 예상보다 행 수가 늘어날 수 있다.
concat()은 인덱스를 기준으로 데이터를 맞춰 붙이기 때문에,
두 결과의 인덱스를 0, 1, 2, ... 형태로 다시 맞춰주기 위해 reset_index(drop=True)를 사용한다.

=> drop=True는 기존 인덱스를 새 컬럼으로 남기지 않고 버린다는 의
'개발 공부 > 머신러닝' 카테고리의 다른 글
| [Machine Learning] 모델은 어떻게 학습할까? | 손실함수, Learning Rate, Gradient Descent (1) | 2026.09.05 |
|---|---|
| [Machine Learning] 회귀 평가지표 7가지 | R², MSE, RMSE, RMSLE, MAE, MAPE, SMAPE (0) | 2026.09.05 |
| [Machine Learning] One-Hot Encoding 정리 | Train/Test 전처리 (2) | 2026.09.05 |
| [Machine Learning] One-Hot Encoding 정리 (0) | 2026.09.04 |
| [Machine Learning] 인공지능·머신러닝·딥러닝과 학습 종류 정리 (0) | 2026.09.03 |