1. 회귀 모델 평가 = 실제값과 예측값의 차이에서 시작
회귀 모델은 연속적인 숫자를 예측한다.
모델이 얼마나 잘 예측했는지는 실제값과 예측값의 차이를 이용해 평가할 수 있다.
예를 들어,
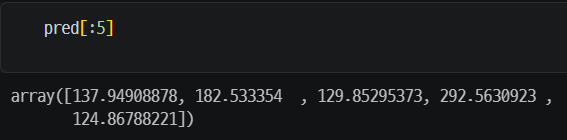
는 모델이 예측한 값이고,

는 실제 정답값이다.
두 값을 비교하면서 예측이 실제값과 얼마나 차이나는지 확인하고,
이 차이를 여러 방식으로 계산한 것이 회귀 평가지표이다.
⠀
2. R² — 모델이 얼마나 잘 설명하는지
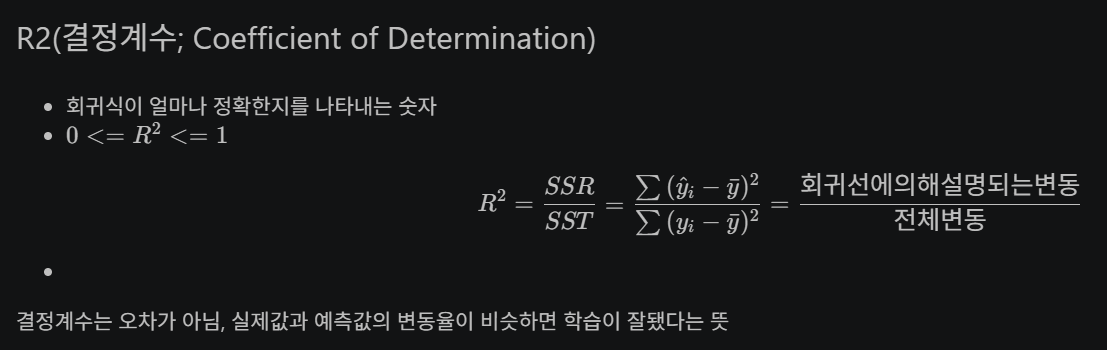
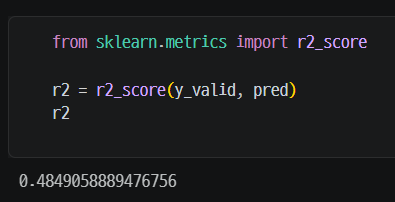
R²는 실제값과 예측값의 단순한 오차 크기를 계산하는 지표가 아니라,
모델이 데이터의 변동을 얼마나 설명하는지 나타내는 지표이다.
값이 클수록 실제 데이터의 변화를 모델이 잘 설명하고 있다고 볼 수 있다.
R²는 전체 변동 중에서 회귀선이 설명하는 변동의 비율이 어느 정도인지를 나타낸다.
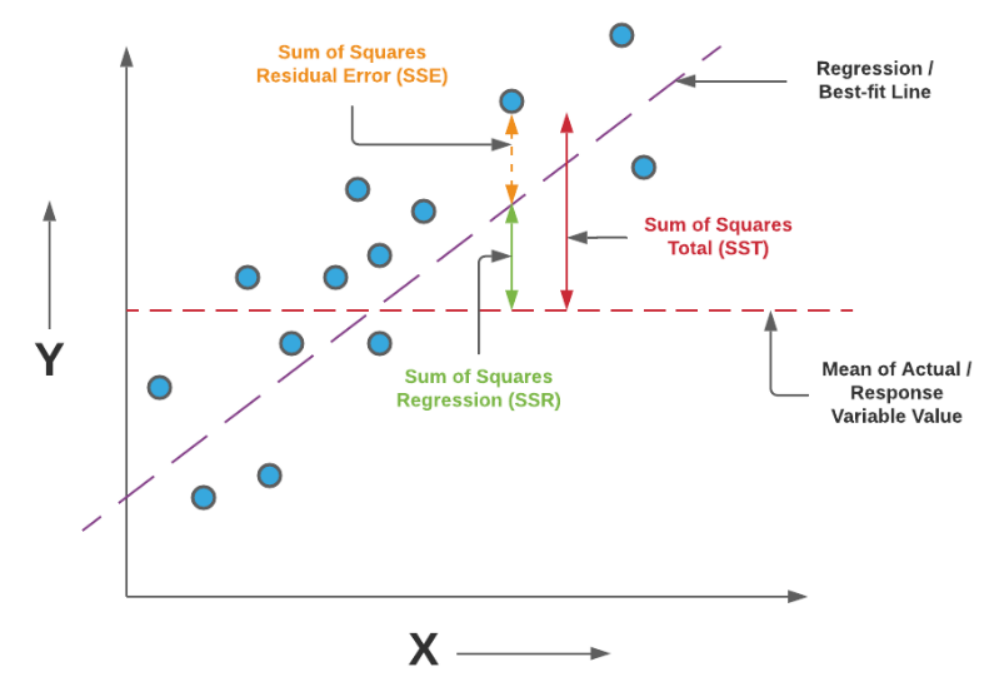
- 분자 : 예측값이 평균값을 기준으로 얼마나 변하는지
- 분모 : 실제값이 평균값을 기준으로 얼마나 변하는지
- ȳ : 실제값의 평균
- ŷ : 예측값
- y : 실제값
⠀
3. MSE → RMSE
1) MSE
실제값과 예측값의 차이를 그대로 더하면 양수와 음수가 서로 상쇄될 수 있다.
예를 들어 오차가 +10, -10이라면 단순히 더했을 때 0이 되어 오차가 없는 것처럼 보일 수 있다.
그래서 MSE는 실제값과 예측값의 차이를 제곱한 뒤 평균을 계산한다.
- 오차가 음수여도 제곱하면 양수가 되기 때문에 오차가 상쇄되지 않는다.
- 큰 오차일수록 제곱값이 더 커지기 때문에 큰 오차에 더 큰 영향을 받는다.
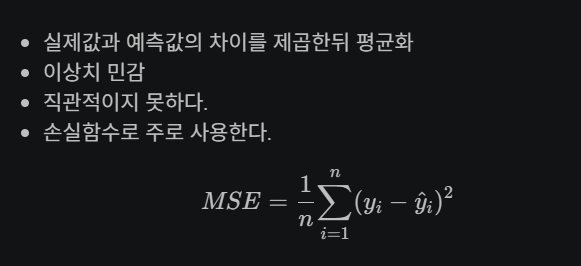
하지만 오차를 제곱하기 때문에 원래 Target과 단위가 달라져 직관적으로 해석하기 어렵다.
이를 보완하기 위해 MSE에 다시 제곱근을 적용한 것이 RMSE이다.
⠀
2) RMSE
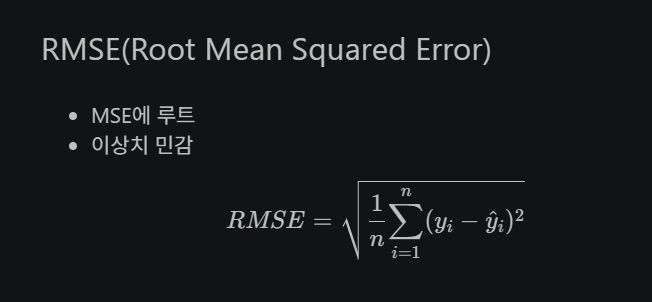
RMSE는 MSE에 제곱근을 적용한 값으로,
제곱 때문에 달라졌던 단위를 원래 Target과 같은 단위로 다시 맞춰준다.
따라서 MSE보다 결과를 직관적으로 해석하기 쉽다. ⠀
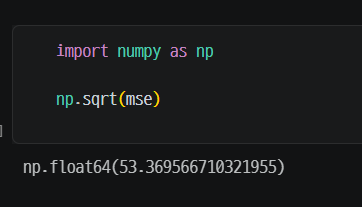
np.sqrt(mse)를 이용해 MSE의 제곱근을 계산할 수 있다.
⠀
4. RMSLE — 로그를 적용해 큰 값의 영향 완화
로그를 적용하면 큰 값의 크기가 압축되기 때문에 큰 값이나 큰 오차가 결과에 미치는 영향이 상대적으로 줄어든다.
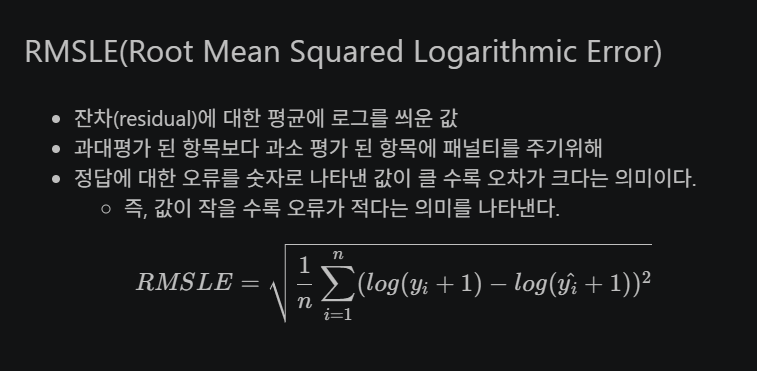
계산 흐름
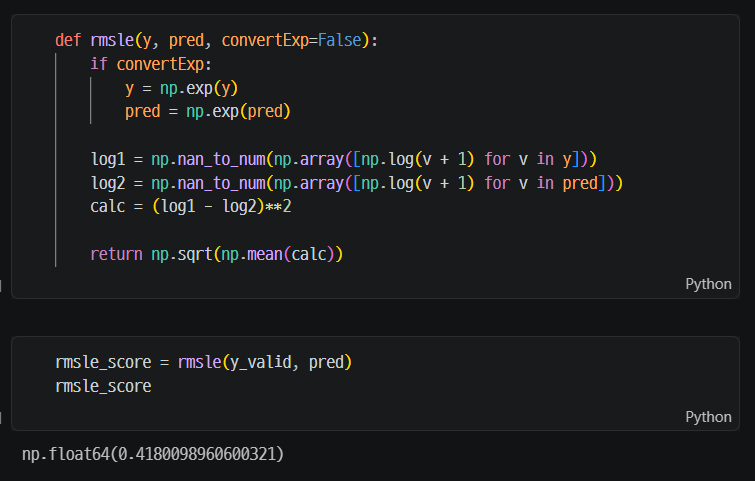
실제값·예측값 → log 적용 → 차이 계산 → 제곱 → 평균 → 제곱근
실제 코드에서도 실제값과 예측값에 각각 np.log(v + 1)을 적용한 뒤 두 값의 차이를 제곱하고, 마지막에 평균과 제곱근을 계산한다.
⠀
5. MAE — 절댓값으로 오차 계산
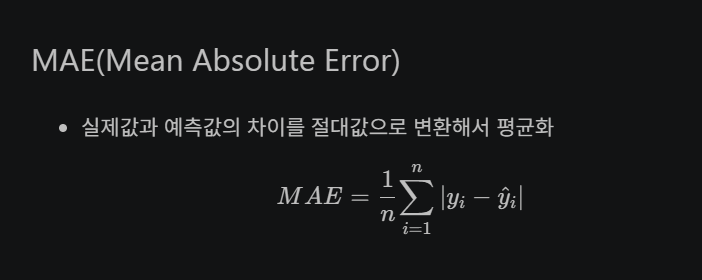
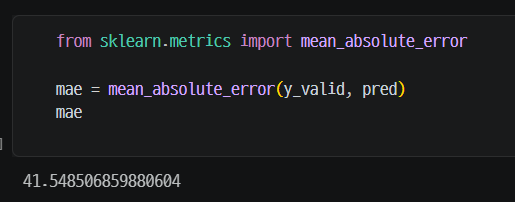
MAE는 오차의 절댓값을 구한 뒤 평균을 계산한다.
제곱과 루트 없이 단순히 음수 부호만 없애기 위해 절댓값을 사용한다.
따라서 양수와 음수가 서로 상쇄되지 않으면서도 평균적으로 실제값과 몇 단위 정도 차이가 나는지 직관적으로 확인할 수 있다.
⠀
6. 왜 비율로 보는 지표가 필요할까?
오차가 50이라고 해도 Target의 규모를 모르면 좋은 값인지 나쁜 값인지 판단하기 어렵다.
이런 절대 숫자의 해석 문제 때문에 비율이 중요하다.
⠀
7. MAPE — 실제값 대비 오차 비율
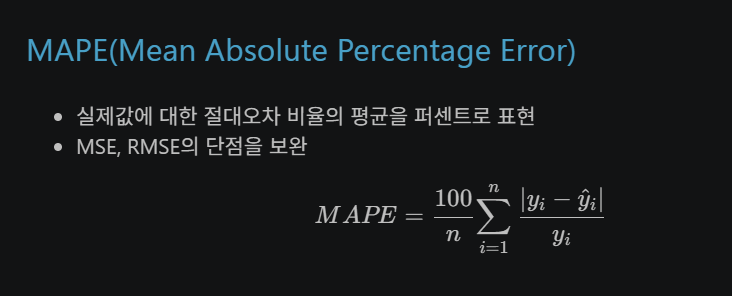
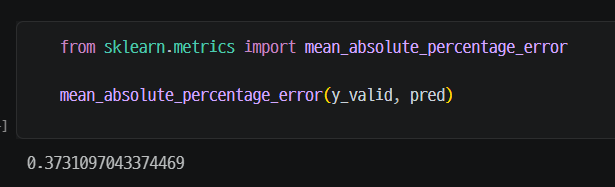
MAPE는 실제값을 기준으로 오차가 어느 정도의 비율인지 계산하는 지표이다.
다만 MAPE의 수식에서는 실제값이 분모에 들어간다.
따라서 실제값이 0이면,
오차
────
 0
이 되어 정상적으로 비율을 계산하기 어렵다는 문제가 있다.
⠀
8. SMAPE — MAPE의 0 분모 문제 완화
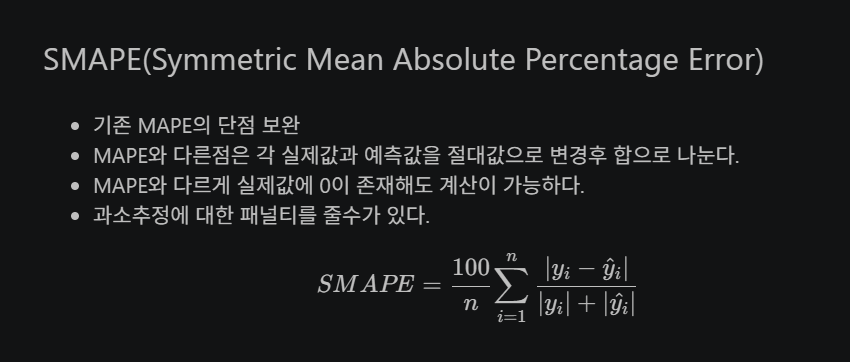
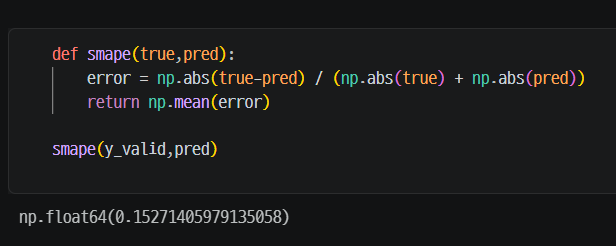
SMAPE는 MAPE와 마찬가지로 오차를 비율로 계산하지만, 분모를 계산하는 방법이 다르다.
MAPE는 실제값만 분모로 사용하지만, SMAPE는 실제값과 예측값의 절댓값을 함께 사용한다.
=> MAPE의 단점을 보완하는 방식 (다만 실제값과 예측값이 둘 다 0이면 분모 역시 0이 될 수 있으므로, 해결이 아니라 완화다.)
⠀
9. 회귀 평가지표 정리
| 지표 | 계산 방법 | 특징 |
| R² | 전체 변동 중 모델이 설명한 정도 | 모델의 설명력 확인 |
| MSE | 오차를 제곱한 뒤 평균 | 오차 상쇄 방지, 큰 오차에 더 큰 영향 |
| RMSE | MSE에 제곱근 적용 | Target과 같은 단위로 해석 가능 |
| RMSLE | 로그 적용 후 RMSE 계산 | 큰 값의 영향 상대적으로 완화 |
| MAE | 절대 오차의 평균 | 평균적으로 몇 단위 차이인지 확인 |
| MAPE | 실제값 대비 오차 비율 | 상대적인 오차 크기 확인 |
| SMAPE | 실제값과 예측값을 함께 이용해 오차 비율 계산 | MAPE의 0 분모 문제 완화 |
각 지표는 오차를 계산하는 방식과 해석 방법이 다르기 때문에, 모델과 데이터의 특성에 맞는 평가지표를 선택하는 것이 중요하다.
⠀
'개발 공부 > 머신러닝' 카테고리의 다른 글
| [Machine Learning] LinearRegression, Ridge, Lasso, ElasticNet | 규제와 alpha 이해하기 (2) | 2026.09.06 |
|---|---|
| [Machine Learning] 모델은 어떻게 학습할까? | 손실함수, Learning Rate, Gradient Descent (1) | 2026.09.05 |
| [Machine Learning] 데이터 스케일링 | StandardScaler, MinMaxScaler (1) | 2026.09.05 |
| [Machine Learning] One-Hot Encoding 정리 | Train/Test 전처리 (2) | 2026.09.05 |
| [Machine Learning] One-Hot Encoding 정리 (0) | 2026.09.04 |