시계열 Window를 만드는 원리는 앞 단계에서 정리했다.
이제 필요한 것은 만들어진 Window의 값 범위를 맞추고, 모델의 출력값을 다시 원래 가격으로 해석할 수 있도록 Dataset을 완성하는 일이다. 이 글에서는 Window 생성 과정을 반복하지 않고 Scaling과 Unscaling에 집중한다.
⠀
1. 왜 시계열 Dataset에 Scaling이 필요할까
Close와 Volume은 값의 단위와 크기가 크게 다르다.
그대로 학습하면 값이 큰 변수의 영향이 지나치게 커질 수 있으므로 각 열을 0과 1 사이로 바꾼다.
scaled = (value - min) / (max - min)
| 기호 | 의미 |
| value - min | 현재 값이 최솟값에서 얼마나 떨어져 있는지 |
| max - min | 그 열 전체의 범위 size |
| 나눗셈 결과 | 전체 범위 중 현재 값의 상대적 위치 |
최솟값은 분자가 0이 되어 0으로 바뀌고, 최댓값은 분자와 분모가 같아져 1로 바뀐다.
Close 열을 실제 숫자로 보면 최솟값은 약 340.431, 최댓값은 약 377.407이고 범위는 약 36.976이다.
첫날 Close 373.270은 `(373.270 - 340.431) / 36.976 ≈ 0.888`로 바뀐다.
373이라는 가격 자체가 아니라, 이 기간의 최솟값과 최댓값 사이에서 약 88.8% 지점에 있다는 뜻이다.
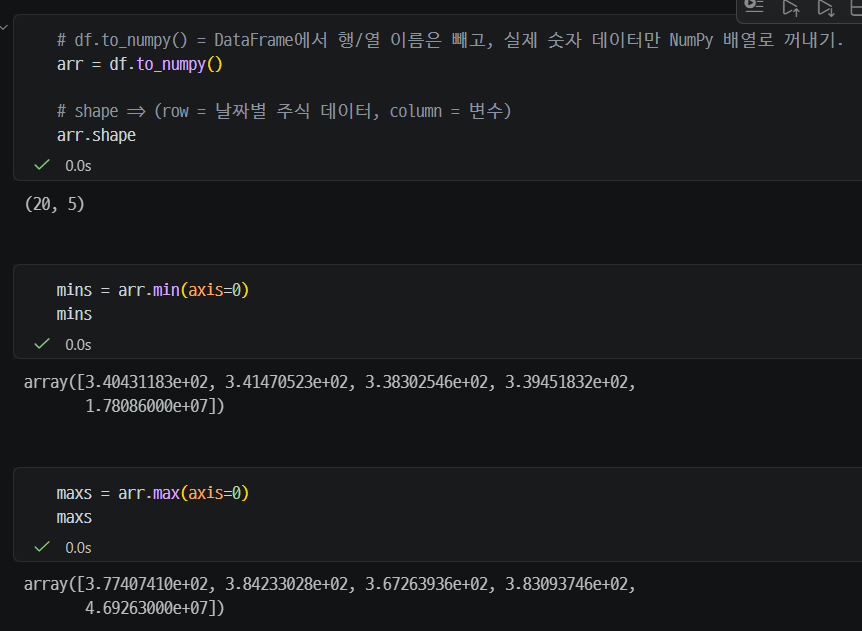
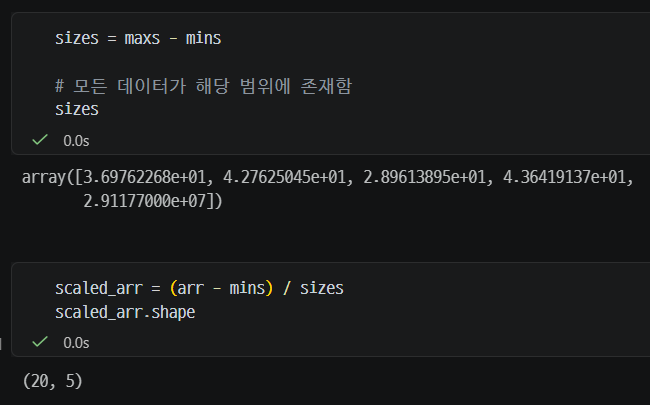
📌 이해 보충 | `axis=0`은 각 열을 기준으로 모든 행을 비교한다.
따라서 Close, High, Low, Open, Volume마다 서로 다른 최솟값과 최댓값이 계산된다.
⠀
2. 예측값을 원래 가격으로 되돌리려면 무엇을 저장해야 할까
original = scaled * size + min
Scaling할 때 최솟값을 빼고 size로 나눴으므로, 원복할 때는 반대로 size를 곱하고 최솟값을 더한다.
앞의 0.888을 되돌리면 `0.888 × 36.976 + 340.431 ≈ 373.270`이 된다.
모델이 Close만 예측한다면 모든 열의 통계값을 저장할 필요 없이 Close의 `min`과 `size`만 기억하면 된다.
| 저장할 값 | 필요한 이유 |
| target 열의 min | Scaling할 때 뺀 값을 다시 더하기 위해 |
| target 열의 size | Scaling할 때 나눈 범위를 다시 곱하기 위해 |
| scaled_arr | 같은 기준으로 Window feature와 target을 만들기 위해 |
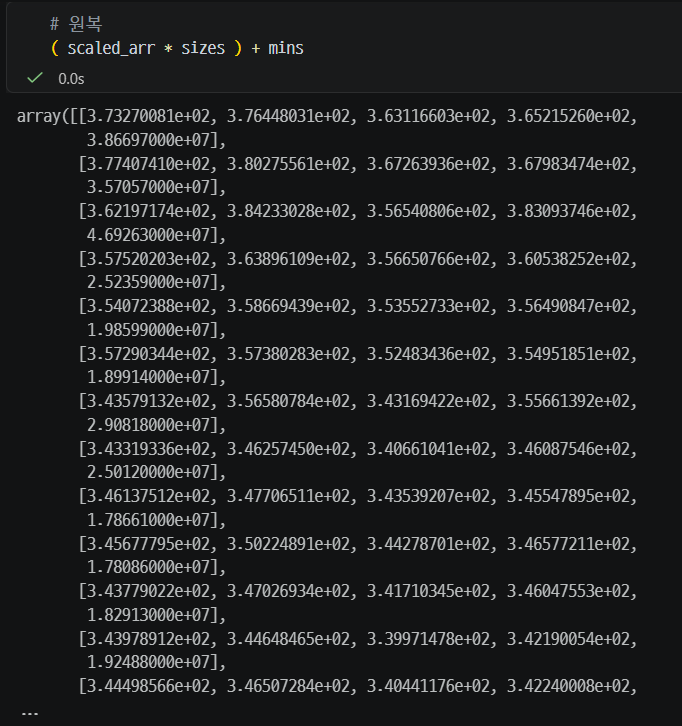
열마다 다른 최솟값과 범위를 사용해 0에서 1 사이로 변환한 결과
⠀
3. 기존 시계열 Dataset에 Scaling 기능을 연결하기
Window 생성 메서드는 그대로 두고, 객체를 만들 때 Scaling을 먼저 실행하도록 순서를 연결한다.
이후 Window는 원본 배열이 아니라 `self.scaled_arr`에서 만들어진다.

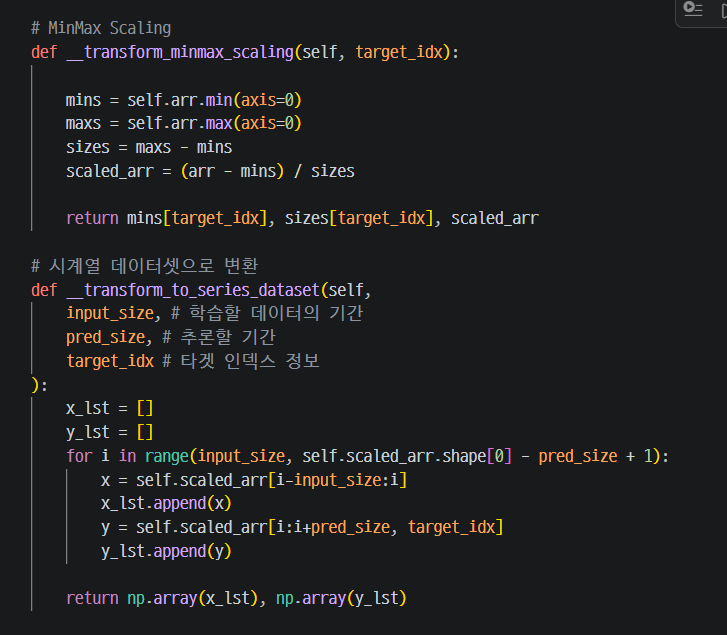
📌 이해 보충 | Window 생성 코드 자체는 달라지지 않는다.
달라지는 부분은 `self.arr` 대신 `self.scaled_arr`를 잘라 feature와 target을 만든다는 점이다.
⠀
왜 target 열의 min과 size만 따로 저장할까
feature에는 다섯 열이 모두 들어가지만 모델이 최종적으로 예측하는 값은 `target_idx=0`, 즉 Close다.
따라서 예측값을 원복할 때는 Close에 적용했던 최솟값과 범위만 있으면 된다.
High나 Volume의 통계값으로 Close 예측값을 되돌리면 단위가 맞지 않는다.
⠀
4. 객체 생성과 데이터 조회는 실행 시점이 다르다
| 실행 코드 | 내부에서 일어나는 일 | 결과 |
| MyDataset(df) | Scaling 실행 후 Window 생성 | min, size, features, targets 저장 |
| len(dataset) | 저장된 features의 길이 확인 | 학습 샘플 수 반환 |
| dataset[0] | 저장된 첫 feature와 target 조회 | 한 샘플 반환 |
| transform_by_unscaling(pred) | pred에 size를 곱하고 min을 더함 | 원래 Close 단위 반환 |
📌 이해 보충 | `dataset[0]`을 실행할 때마다 MinMax Scaling과 모든 Window를 다시 만드는 것이 아니다.
이 구현에서는 객체를 생성할 때 전처리를 한 번 끝내고,
조회할 때는 저장된 `self.features[0]`과 `self.targets[0]`만 꺼낸다.
⠀
5. 핵심 정리
| 개념 | 기억할 내용 |
| MinMax Scaling | 열마다 최솟값과 범위를 사용해 0에서 1 사이로 변환 |
| target_idx | 예측값 원복에 사용할 target 열 선택 |
| self.min, self.size | target Scaling에 사용한 정보를 저장 |
| scaled_arr | Scaling된 값으로 시계열 Window 생성 |
| Unscaling | 모델 출력을 원래 Close 단위로 되돌림 |
28일차 시계열 파트의 핵심은 Window를 다시 만드는 법이 아니라 전처리 기준을 Dataset 안에 저장하는 것이다.
그래야 학습용 값은 일정한 범위로 바꾸고, 모델의 결과는 다시 사람이 이해할 수 있는 가격 단위로 되돌릴 수 있다.
'개발 공부 > 딥러닝' 카테고리의 다른 글
| [Deep Learning] PyTorch 모델 구조를 단순화하고 예측값 해석하기 (0) | 2026.09.26 |
|---|---|
| [Deep Learning] PyTorch 신경망 모델 직접 만들기 (0) | 2026.09.26 |
| [Deep Learning] 표 데이터와 시계열 데이터도 Dataset으로 만들기 (0) | 2026.09.25 |
| [Deep Learning] PyTorch Custom Dataset 만들기 (0) | 2026.09.25 |
| [Deep Learning] Hugging Face란? (0) | 2026.09.24 |