이전에는 이미지 전처리와 CNN의 기본 구조를 개념적으로 살펴봤다. 이번에는 실제 손글씨 이미지 데이터를 이용해 Dataset과 DataLoader를 만들고, Conv2d와 MaxPool2d를 직접 적용한 뒤 CNNModel까지 구현했다.
#PyTorch #CNN #Conv2d #MaxPool2d #FeatureMap #load_digits #DeepLearning #딥러닝공부
⠀
1. load_digits 손글씨 데이터 불러오기
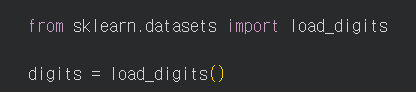
이번 실습에서는 sklearn의 load_digits() 데이터를 사용했다.
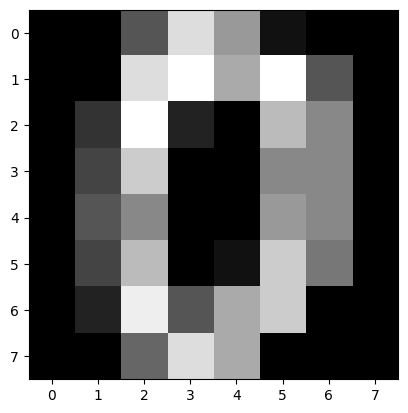
각 이미지는 8×8 크기의 흑백 손글씨 이미지이고, Target은 0~9 숫자 Class다.
⠀
2. Train / Test 데이터 분리
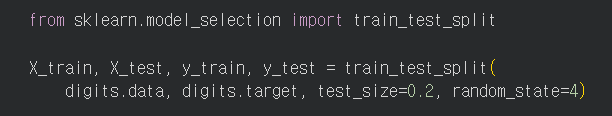
실행 결과는
Train → 1,437개
Test  → 360개
였다.
⠀
3. 사용자 정의 Dataset 만들기
digits.data는 각 이미지가 길이 64의 Vector로 들어 있기 때문에 __getitem__()에서 다시 8×8 형태로 바꾼 뒤 ToTensor()를 적용했다.
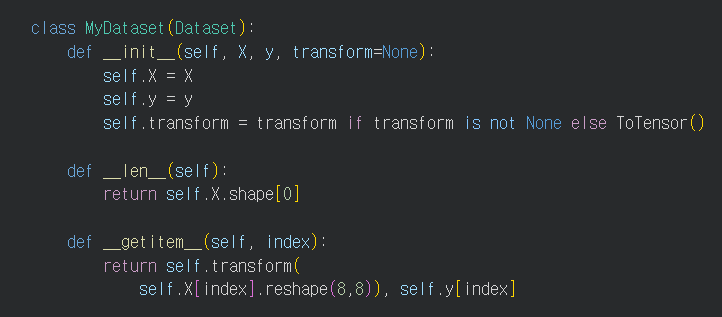
하나의 Feature Shape은
(1, 8, 8)이며, 첫 번째 1은 흑백 Channel을 의미한다.
⠀
4. DataLoader로 Batch 만들기
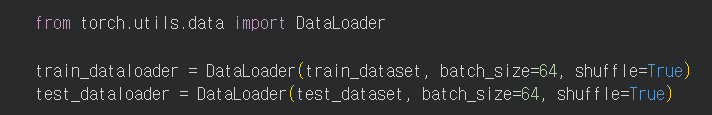
한 Batch의 Shape은
(64, 1, 8, 8)이다.
즉
(batch, color, row, column)구조가 만들어진다.
⠀
5. Conv2d는 이미지에서 Feature Map을 만든다

in_channels=1은 흑백 이미지가 한 장의 Channel로 구성된다는 뜻이고,
out_channels=10은 Convolution을 통해 10개의 Feature Map을 만든다는 뜻이다.
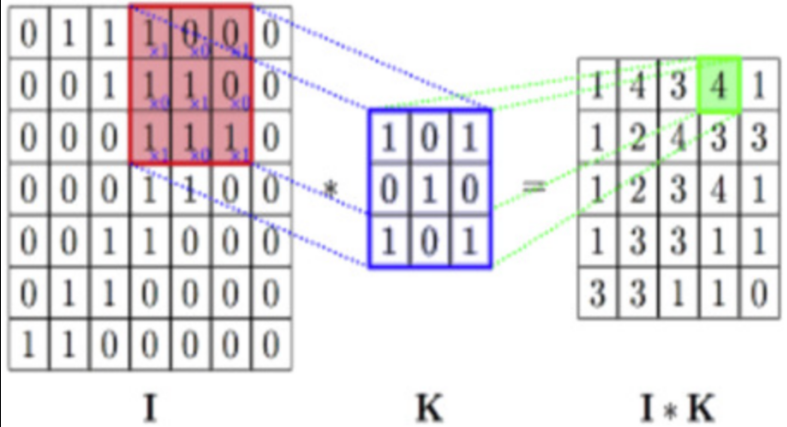
실제 Batch
(64, 1, 8, 8)를 Conv2d에 넣었을 때 출력 Shape은
(64, 10, 6, 6)이었다.
Batch 수는 그대로이고, Feature Map이 10개로 늘어난 것을 확인할 수 있다.
⠀
6. MaxPool2d는 Feature Map의 크기를 줄인다
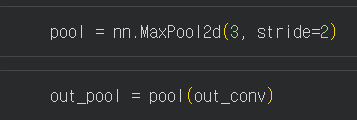
Pooling을 적용하면
Batch
Feature Map 개수
는 유지되고,
각 Feature Map의
Row
Column
크기만 줄어든다.
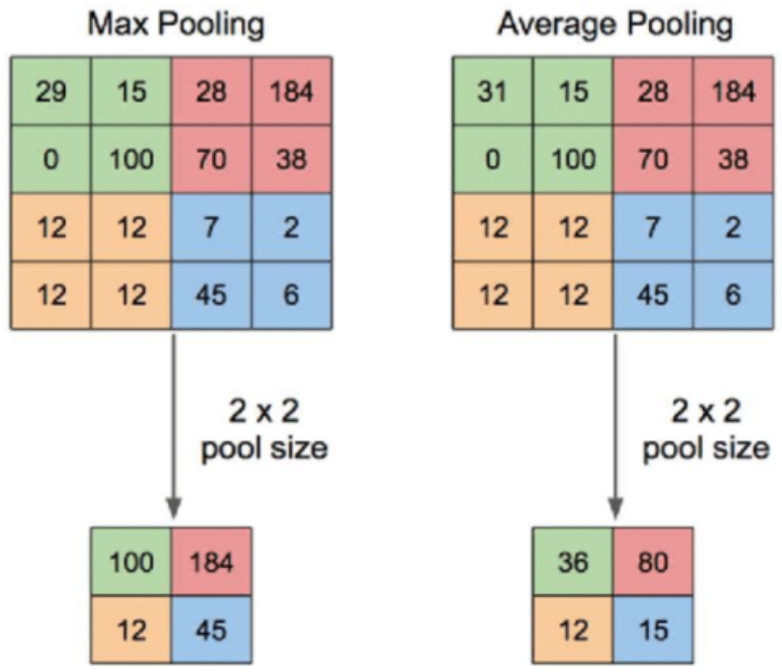
강의에서는 최근 CNN 구조에서 Max Pooling을 자주 사용하는 이유를, 강한 특징을 더 남기는 방식으로 설명했다.
평균을 내는 Average Pooling보다 눈에 띄는 값이 유지되기 쉽다는 관점이다.
⠀
7. ConvLayer 만들기
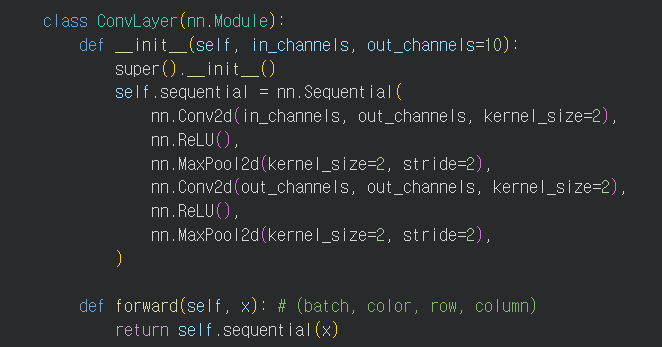
이번 모델에서는
Conv2d
↓
ReLU
↓
MaxPool2d
를 두 번 반복해 이미지에서 특징을 추출하고 압축했다.
⠀
8. DenseLayer는 최종 Target을 예측한다

ConvLayer와 Pooling은 이미지에서 Feature를 추출하고,
마지막 DenseLayer에서
Flatten
↓
Linear Layer
↓
Class Prediction
과정을 통해 0~9 Class를 예측한다.
⠀
9. ConvLayer + DenseLayer = CNNModel
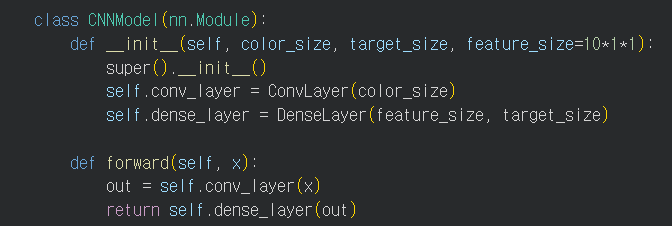
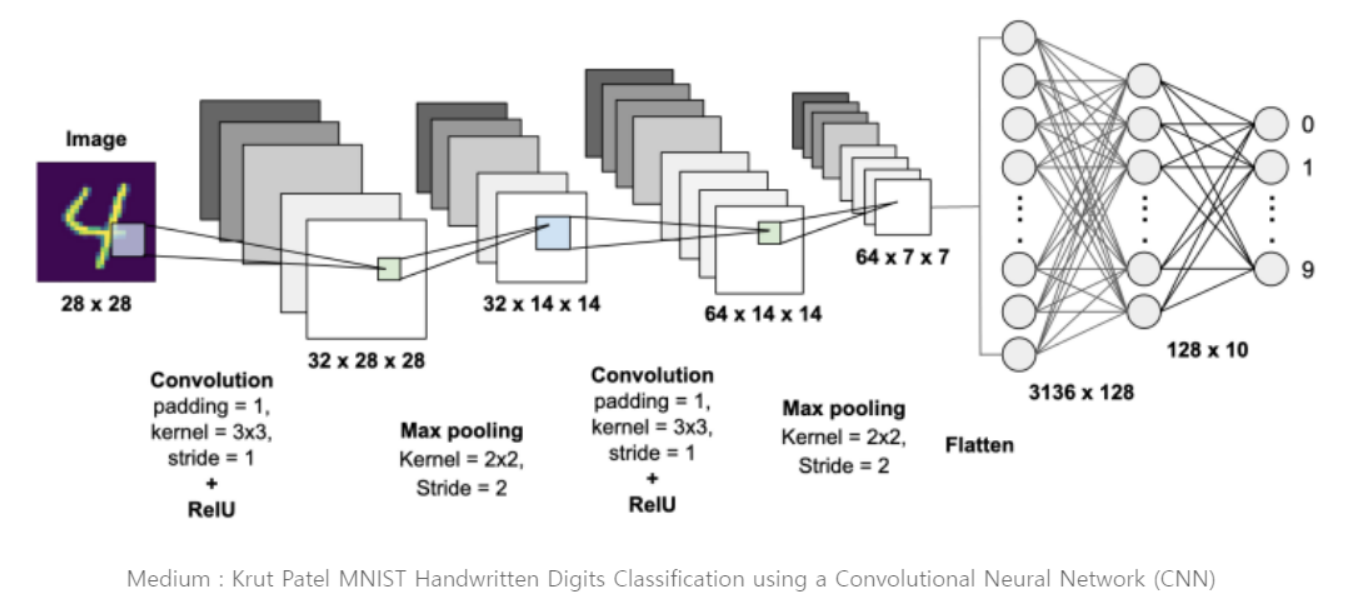
즉 전체 CNN은
Image
↓
ConvLayer
↓
Feature 추출 / 압축
↓
DenseLayer
↓
Target Prediction
구조로 연결된다.
⠀
10. 학습과 평가
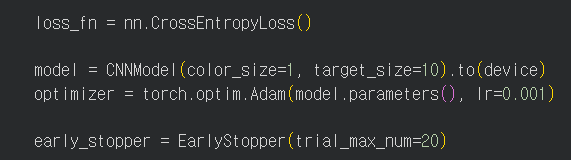
다중분류이므로 CrossEntropyLoss를 사용했고,
Adam Optimizer와 Early Stopping을 적용했다.
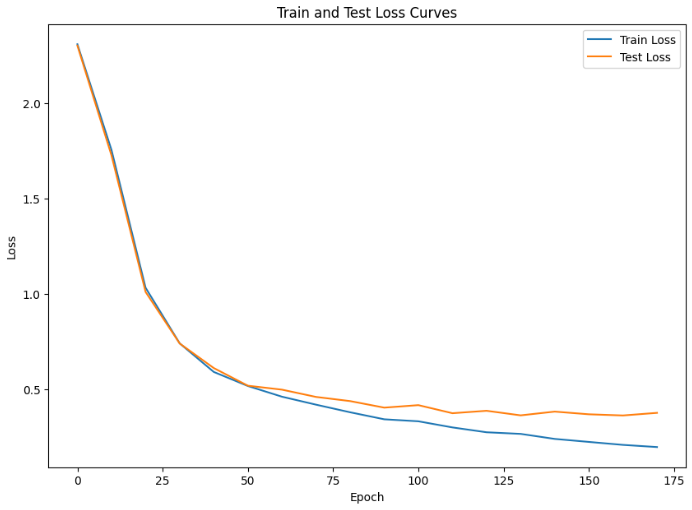
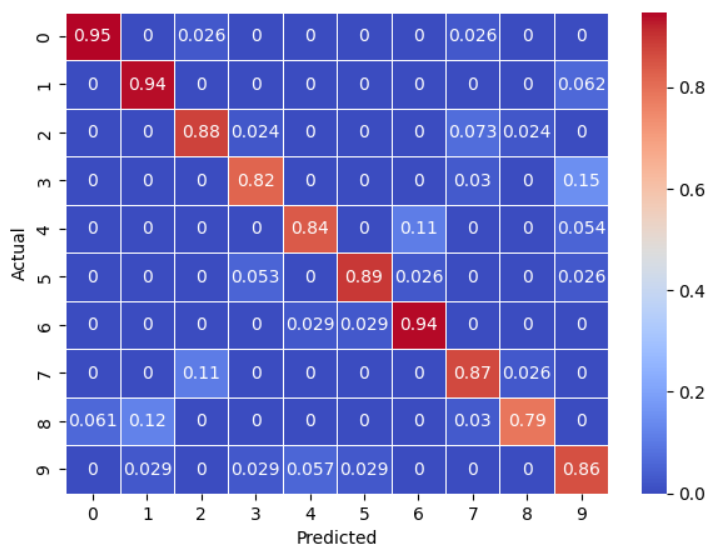
Best Model을 이용한 실행 결과에서
F1 Score ≈ 0.902로 확인됐다.
⠀
11. 핵심 정리
개념기억할 내용
| Conv2d | 이미지의 주변 영역을 보면서 Feature Map 생성 |
| out_channels | 생성할 Feature Map의 개수 |
| MaxPool2d | Feature Map의 Row / Column 크기를 줄여 압축 |
| ConvLayer | Convolution + ReLU + Pooling을 반복하며 특징 추출 |
| DenseLayer | Flatten 후 Linear Layer로 최종 Class 예측 |
| CNNModel | ConvLayer와 DenseLayer를 하나의 모델로 연결 |