지금까지 이미지 데이터를 Flatten()한 뒤 Linear Layer에 넣어 분류했다.
하지만 이미지에는 단순한 픽셀값뿐만 아니라
어떤 특징이 어디에 위치하는지
라는 공간 정보도 중요하다.
이번에는 기본적인 이미지 전처리 방법을 살펴보고, 왜 이미지 처리에서 CNN이 많이 사용되는지 개념적으로 정리했다.
#CNN #Convolution #Pooling #ImagePreprocessing #ComputerVision #FeatureMap #DataAugmentation #PyTorch #딥러닝공부
⠀
1. 이미지는 RGB 숫자 Matrix의 집합
컬러 이미지는
Red Matrix
+
Green Matrix
+
Blue Matrix
로 구성되어 있다.
즉 컴퓨터 입장에서는 이미지가 특별한 사진이 아니라 숫자가 배치되어 있는 Matrix 데이터다.
그리고 픽셀값을 어떻게 조작하느냐에 따라 이미지의 형태도 달라진다.
이 원리를 이용해 다양한 이미지 전처리를 할 수 있다.
⠀
2. Erosion과 Dilation
강의에서 먼저 살펴본 것은 침식과 확장이었다.
Erosion
침식은 이미지에서 데이터가 존재하는 영역을 줄이는 방향으로 작동한다.
결과적으로
두꺼운 영역
↓
얇은 영역
처럼 보일 수 있다.
Dilation
확장은 반대다.
데이터가 존재하는 영역을 더 넓혀
얇은 영역
↓
두꺼운 영역
처럼 만든다.
두 방법 모두 작은 Kernel을 이미지 위에서 이동시키며 주변 픽셀 정보를 기준으로 처리하는 방식이다.
⠀
3. Gaussian Blur
두 번째는 Gaussian Blur다.
이미지의 픽셀값을 주변 값과 함께 계산하면서 이미지를 부드럽게 만든다.
선명한 이미지

↓

Gaussian Blur

↓

흐릿한 이미지
즉 한 픽셀만 독립적으로 보는 것이 아니라 주변 픽셀을 함께 본다.
⠀
4. Edge Detection
세 번째는 Edge Detection이다.
이미지의 경계 부분에서는 픽셀값이 급격하게 변한다.
예를 들어
어두운 영역
→
밝은 영역
으로 바뀌는 부분에서는 숫자의 변화가 크다.
반대로 같은 색상이 계속되는 영역은 변화가 작다.
따라서
값의 변화가 큰 부분 → Edge
값의 변화가 작은 부분 → 제거
하는 방식으로 경계선만 추출할 수 있다.
⠀
5. Edge가 실제로 활용될 수 있는 곳
강의에서는 Smart Factory의 불량 검사 예시가 나왔다.
제품의
찍힘
깨짐
형태 이상
경계 이상
을 확인해야 할 때 원본 컬러 이미지 전체를 그대로 사용하는 것보다 필요한 특징만 강조해서 모델에 전달할 수 있다.
예를 들어 색상이 중요하지 않고 제품의 형태나 흠집만 중요하다면
컬러 이미지
↓
흑백
↓
Edge 추출
↓
모델
처럼 단순화할 수 있다.
⠀
6. 그런데 왜 이미지에서 Linear Layer만 사용하면 아쉬울까?
지금까지 사용했던 모델에서는 이미지를 먼저
nn.Flatten()했다.
예를 들어
(3, 200, 200)

↓

Flatten

↓

(120000,)
형태가 된다.
문제는 이 과정에서 원래 이미지가 가지고 있던 공간적인 구조를 직접 활용하기 어려워진다는 점이다.
우리가 어떤 동물을 볼 때도
귀
눈
코
뿔
몸
을 각각 독립적인 숫자로 보고 판단하지 않는다.
각 특징의 모양과 위치 관계를 함께 보고 판단한다.
⠀
7. 이미지는 위치 정보가 중요하다
예를 들어 공이라는 특징이 있다고 해도
손 근처에 있는 공과
발 근처에 있는 공은 의미가 다를 수 있다.
즉 이미지에서는
어떤 특징이 존재하는가
+
그 특징이 어디에 존재하는가
가 중요하다.
그래서 이미지 전체를 단순히 1차원으로 펼치는 것보다 면 형태를 유지하면서 주변 정보까지 함께 분석하는 방법이 필요하다.
그 대표적인 구조가 CNN이다.
⠀
8. CNN은 Conv2d로 이미지의 면을 본다
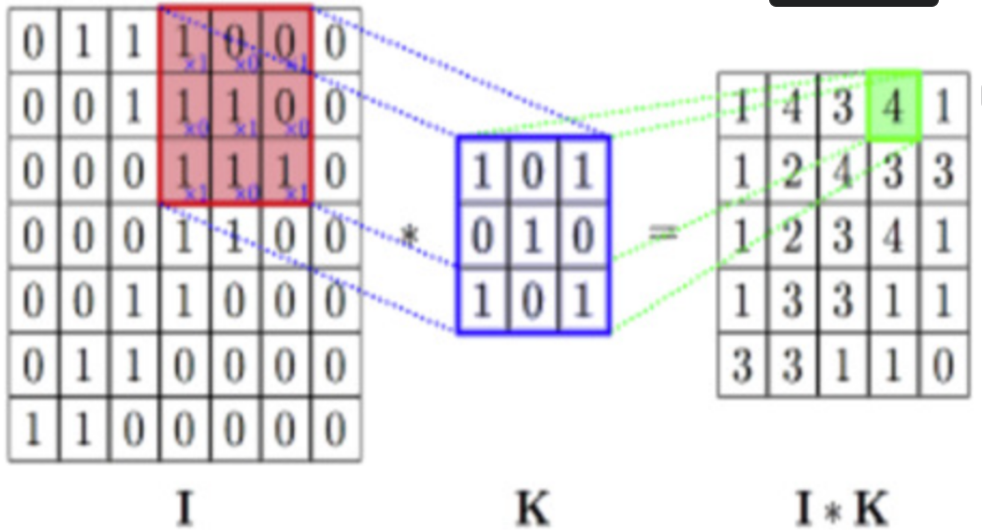
CNN에서는 nn.Conv2d()를 사용해 작은 Kernel이 이미지 위를 이동하면서 특징을 추출한다.
이번 실습에서는 다음과 같은 예제를 확인했다.
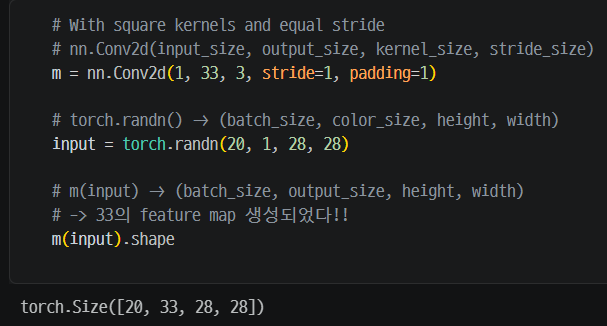
입력 Shape은
(batch, channel, height, width)

↓

(20, 1, 28, 28)
이고,
out_channels=33이기 때문에 Convolution을 통과한 뒤 33개의 Feature Map이 만들어진다.
⠀
9. Conv2d의 주요 설정값
nn.Conv2d()에서 자주 확인해야 하는 값은 다음과 같다.
in_channels
→ 입력 Channel 수

out_channels
→ 만들어낼 Feature Map 수

kernel_size
→ Kernel 크기

stride
→ Kernel이 한 번에 이동하는 간격

padding
→ 이미지 바깥에 추가하는 여백
이번 코드에서는
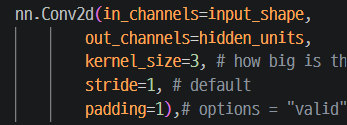
을 사용했다.
즉 3×3 크기의 Kernel이 한 칸씩 이동하면서 이미지를 분석한다.
⠀
10. Convolution의 결과는 Feature Map
Convolution Layer를 통과한 결과는 다시 면 형태로 나온다.
Image

↓

Convolution

↓

Feature Map
이번 실습에서도
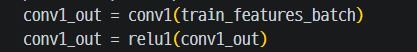
처럼 Convolution과 ReLU를 차례대로 적용했다.
출력 Shape은
(batch_size,
 feature_map_size,
 feature_map_height,
 feature_map_width)
형태가 된다.
즉 Convolution을 적용해도 이미지의 공간 구조가 완전히 사라지는 것이 아니라 Feature Map 형태로 유지된다.
⠀
11. ReLU는 Shape을 바꾸지 않는다
CNN에서도 Convolution Layer 뒤에 ReLU를 사용했다.
nn.ReLU()ReLU는 값을 변경하지만 Tensor의 차원 자체를 바꾸지는 않는다.
즉
Conv2d
↓
Feature Map
↓
ReLU
↓
Shape 유지
라고 볼 수 있다.
이 부분은 앞에서 배운 ReLU와 동일하다.
⠀
12. Pooling은 Feature Map을 압축한다
Convolution을 통해 Feature Map을 만들고 나면 MaxPool2d()를 이용해 크기를 줄일 수 있다.
이번 실습에서는
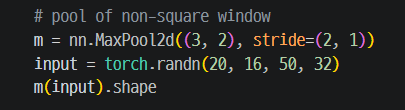
처럼 사용했다.
Max Pooling은 일정 영역 안에서 가장 큰 값을 선택해 Feature Map의 크기를 줄인다.
즉
큰 Feature Map

↓

MaxPool2d

↓

작은 Feature Map
형태가 된다.
📌 이미지 넣기
여기에는 노트북의 nn.MaxPool2d() 바로 아래에 있는 Pooling 설명 그림을 넣으면 좋다.
⠀
13. 실제 CNN에서는 Convolution과 Pooling을 반복한다
실제 모델에서는 Convolution을 한 번만 사용하지 않았다.
이번 CNNModelV1의 첫 번째 Block은 다음과 같다.
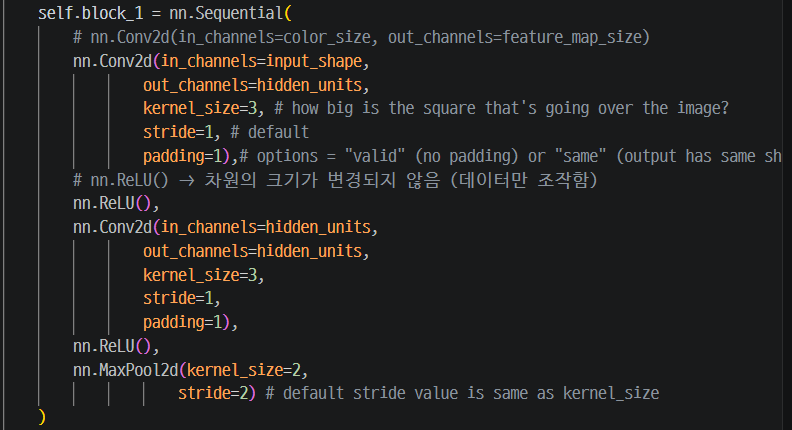
즉
Conv2d
↓
ReLU
↓
Conv2d
↓
ReLU
↓
MaxPool2d
순서로 구성되어 있다.
두 번째 Block에서도 같은 방식으로
특징 추출
↓
특징 추출
↓
크기 압축
을 반복한다.
⠀
14. block_1과 block_2에서 Shape이 어떻게 바뀌는지 확인
이번 실습에서는 CNN을 한 번에 실행하기 전에 각 Block을 따로 실행해 Shape을 확인했다.
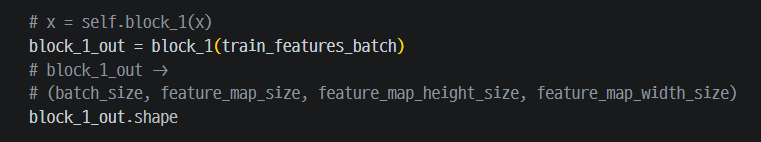
그리고
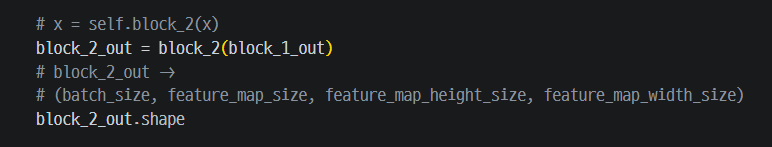
처럼 다음 Block에도 전달했다.
즉 CNN에서는
Input Image

↓

block_1
Convolution + Pooling

↓

block_2
Convolution + Pooling

↓

압축된 Feature Map
형태로 이미지의 특징을 점점 추출하고 압축한다.
⠀
15. 마지막에는 Flatten과 Linear Layer로 연결한다
Convolution과 Pooling을 반복한 뒤에는 다시 지금까지 배웠던 Fully Connected 구조를 사용한다.
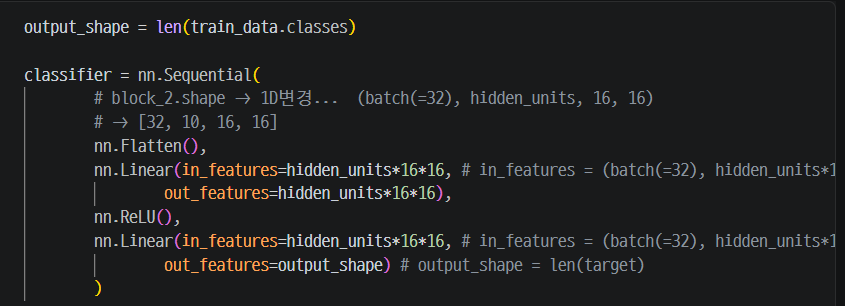
즉 앞부분에서는 이미지의 공간 정보를 유지하면서 특징을 뽑고,
마지막에
Feature Map
↓
Flatten
↓
Linear
↓
Class Prediction
으로 연결된다.
따라서 CNN이라고 해서 기존에 배운 Linear Layer가 사라지는 것은 아니다.
역할이 나뉜다고 이해하면 된다.
Convolution / Pooling
→ 이미지 특징 추출

Fully Connected
→ 추출된 특징으로 최종 예측
⠀
16. 실제 CNNModelV1의 전체 구조
이번 실습에서 사용한 모델은 크게 세 부분으로 나눌 수 있다.
block_1

↓

block_2

↓

classifier
각 역할은 다음과 같다.
block_1
→ Conv + ReLU + Conv + ReLU + Pooling

block_2
→ Conv + ReLU + Conv + ReLU + Pooling

classifier
→ Flatten + Linear + ReLU + Linear
전체 흐름으로 보면
Image
↓
Convolution
↓
Feature Map
↓
Pooling
↓
Convolution
↓
Feature Map
↓
Pooling
↓
Flatten
↓
Linear
↓
Prediction
이다.
⠀
17. CNN에서도 Data Augmentation을 적용할 수 있다
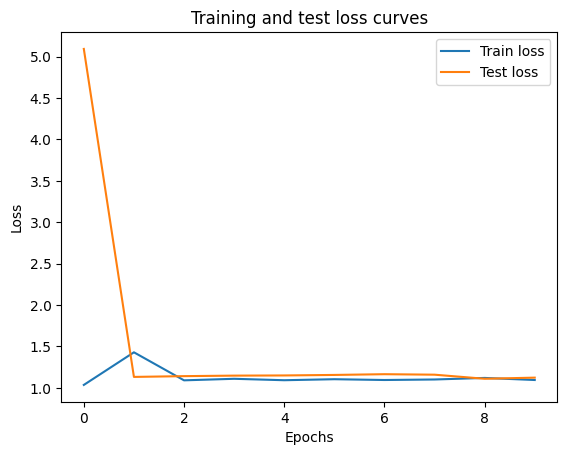
이번 노트북에서는 CNN 학습과 함께 Data Augmentation도 적용했다.
Train Transform에는

을 사용했다.
즉 학습 이미지에는 일정 확률로
좌우 반전
위아래 반전
을 적용했다.
같은 원본 이미지라도 조금씩 다른 형태로 학습에 사용할 수 있는 것이다.
⠀
18. Test에는 Random Augmentation을 적용하지 않았다
Test Transform은 다음과 같이 구성했다.
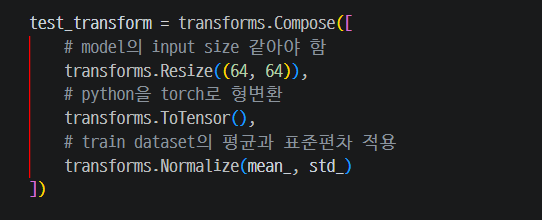
Train과 달리
RandomHorizontalFlip
RandomVerticalFlip
이 없다.
평가 데이터는 매번 Random하게 변형하는 것이 아니라 같은 조건에서 일관되게 평가해야 하기 때문이다.
즉 이번 실습에서는
Train
→ Resize
→ ToTensor
→ Normalize
→ Random Flip

Test
→ Resize
→ ToTensor
→ Normalize
로 구성했다.
⠀
19. CNN과 Data Augmentation 전체 흐름
Train Image
↓
Resize
↓
ToTensor
↓
Normalize
↓
Random Augmentation
↓
DataLoader
↓
Conv2d
↓
ReLU
↓
Conv2d
↓
ReLU
↓
MaxPool2d
↓
Conv2d / Pooling 반복
↓
Feature Map
↓
Flatten
↓
Linear
↓
Prediction
⠀
20. 핵심 정리
개념기억할 내용
| Conv2d | 이미지의 주변 영역을 보며 특징 추출 |
| in_channels | 입력 이미지의 Channel 수 |
| out_channels | 생성할 Feature Map 수 |
| kernel_size | Kernel 크기 |
| stride | Kernel 이동 간격 |
| padding | 이미지 가장자리 여백 |
| Feature Map | Convolution으로 추출된 특징 |
| ReLU | 값은 변경하지만 Shape은 유지 |
| MaxPool2d | Feature Map 크기를 압축 |
| Flatten | Feature Map을 1차원으로 변경 |
| Fully Connected | 추출된 특징으로 최종 Class 예측 |
| Data Augmentation | 학습 이미지에 변형을 적용 |
| RandomHorizontalFlip | 일정 확률로 좌우 반전 |
| RandomVerticalFlip | 일정 확률로 위아래 반전 |
이번 파트에서 가장 중요했던 점은 이미지는 단순한 픽셀값의 나열이 아니라 픽셀 사이의 위치 관계가 중요한 데이터라는 것이었다.
그래서 CNN에서는 Conv2d를 이용해 이미지의 면을 유지하면서 특징을 추출하고,
Convolution
↓
Pooling
↓
Feature 추출 및 압축
↓
Flatten
↓
Fully Connected
↓
Prediction
하는 구조를 사용한다.
또 Train 데이터에는 Data Augmentation을 적용해 같은 이미지를 다양한 형태로 학습에 사용할 수 있다는 점도 확인했다.