CNN 모델을 만들고 나면 학습할 때마다
Training Loop
Early Stopping
평가
그래프
코드를 반복해서 작성하게 된다.
이번에는 자주 사용하는 코드를 Python 파일로 분리해 필요한 기능만 import해서 사용하는 방식으로 정리했다.
⠀
1. 반복되는 코드는 모듈로 분리하기
강의에서는 deep_learning 폴더 아래에 기능별 Python 파일을 만들고,
모델 학습 코드에서는 필요한 함수와 Class만 import해서 사용했다.
deep_learning/
├─ earlystopper.py
├─ training.py
├─ metrics.py
├─ inference.py
└─ plots.py
핵심은 모델이 바뀌어도 학습과 평가 과정은 거의 동일하기 때문에 반복되는 부분을 함수와 Class로 분리해 재사용하는 것이다.
⠀
2. EarlyStopper를 별도 파일로 분리
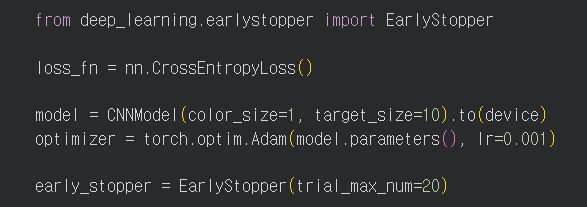
EarlyStopper는 Test Loss가 좋아지는 시점의 Best Model을 저장하고,
성능이 더 이상 개선되지 않는 상태가 일정 횟수 이상 반복되면 학습을 중단하는 역할을 한다.
⠀
3. Training Loop도 함수 하나로 실행
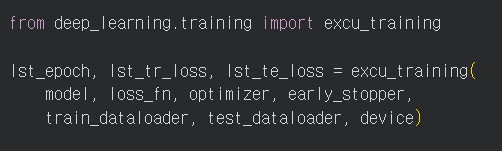
이제 Notebook에서는 Epoch 반복문을 길게 작성하지 않고
model
loss_fn
optimizer
DataLoader
device
등을 넘겨주면 학습 결과를 받을 수 있다.
반환값은
Epoch
Train Loss
Test Loss
로 구성되어 이후 Loss Curve를 그릴 때 그대로 사용할 수 있다.
⠀
4. 평가 지표도 함수로 분리
from deep_learning.metrics import f1_score_fn평가 함수를 따로 만들면
Accuracy
F1 Score
등 원하는 Metric을 바꿔 끼우는 형태로 사용할 수 있다.
강의에서는 함수 이름까지 출력되도록 구성해 어떤 지표를 사용했는지 확인할 수 있게 했다.
⠀
5. Inference 함수로 실제값과 예측값 받기
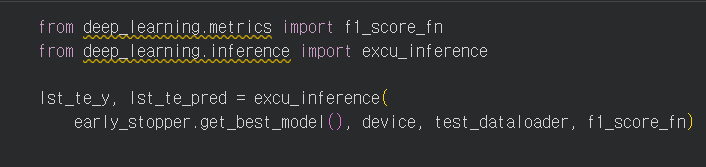
Inference에서는 Early Stopping으로 저장된 Best Model을 가져오고,
Test DataLoader를 이용해
실제값
예측값
을 만든다.
실제값과 예측값은 이후 Confusion Matrix나 Heatmap을 그릴 때 다시 사용된다.
⠀
6. Heatmap도 함수 하나로 정리
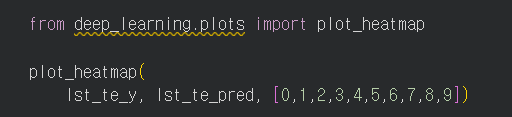
매번
Confusion Matrix 계산
↓
Heatmap 생성
코드를 다시 작성할 필요 없이
실제값
예측값
Class 이름
만 전달하도록 만들었다.
⠀
7. 모듈화 후 전체 코드가 짧아진다
Model 생성
↓
Loss / Optimizer / EarlyStopper 설정
↓
excu_training()
↓
Best Model
↓
excu_inference()
↓
Metric + Heatmap
딥러닝에서는 Dataset과 모델 구조는 문제마다 달라질 수 있지만,
학습과 평가의 기본 흐름은 반복되는 경우가 많다.
그래서 공통 코드를 모듈화하면 이후 새로운 모델을 실험할 때 훨씬 간단하게 재사용할 수 있다.
'개발 공부 > 딥러닝' 카테고리의 다른 글
| [Deep Learning] VGG 학습 전 이미지 전처리 | Normalize, RandomCrop과 Resize (1) | 2026.09.27 |
|---|---|
| [Deep Learning] CIFAR10 컬러 이미지 CNN | 흑백 CNN에서 RGB CNN으로 확장하기 (0) | 2026.09.27 |
| [Deep Learning] PyTorch CNN 직접 구현 | Conv2d, MaxPool2d와 CNNModel (0) | 2026.09.27 |
| [Deep Learning] 이미지 전처리와 CNN | 왜 이미지는 Linear Layer만으로 부족할까? (0) | 2026.09.27 |
| [Deep Learning] 이미지 Normalize와 PIL·OpenCV 전처리 | RGB부터 영상 Frame까지 (0) | 2026.09.27 |