머신러닝 모델은 문자열을 그대로 계산할 수 없기 때문에 범주형 데이터를 숫자로 바꾸는 인코딩이 필요하다. 하지만 범주의 의미와 데이터 크기에 따라 적절한 방식이 달라지고, 학습·테스트 데이터에 같은 규칙을 적용해야 한다.
1. 데이터 유형 종류
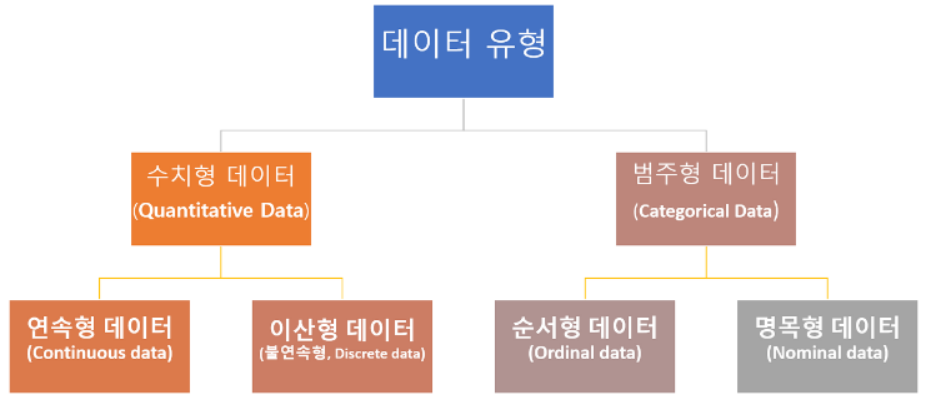
- 수치형: 크기와 차이를 계산할 수 있는 연속형(값이 소수점까지)·이산형(개수만 셀 수 있는) 데이터
- 범주형: 종류를 구분하는 명목형(단순 종류)과 순서를 가진 순서형(크기순) 데이터
주의 0·1·2처럼 숫자로 저장됐어도 의미가 성별·등급·상태라면 범주형일 수 있다. dtype만 보지 말고 값의 의미를 함께 확인한다.
2. 인코딩 방법
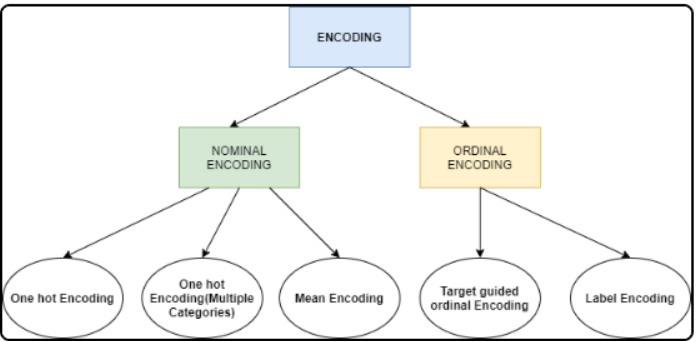
- One-Hot Encoding: 범주마다 0/1 컬럼을 만듬
- Mean Encoding: 각 범주의 타겟 평균으로 바꿈
- Label/Ordinal Encoding: 범주에 정수 번호를 부여
- Target-guided Ordinal Encoding: 타겟 통계를 기준으로 범주 순서 만듬
선택 원칙 정답이 하나로 고정된 것은 아니다. 원-핫 인코딩을 기준선으로 먼저 시도하고,
차원이 지나치게 커지거나 성능이 부족할 때 다른 방법을 교차검증으로 비교한다.
1) One-Hot Encoding
import category_encoders as ce
encoder = ce.OneHotEncoder(use_cat_names=True)
df_encoded = encoder.fit_transform(df)
df_encoded.head()
실행 결과
color_Blue color_Green color_Red
0 0 0 1
1 1 0 0
2 0 1 0
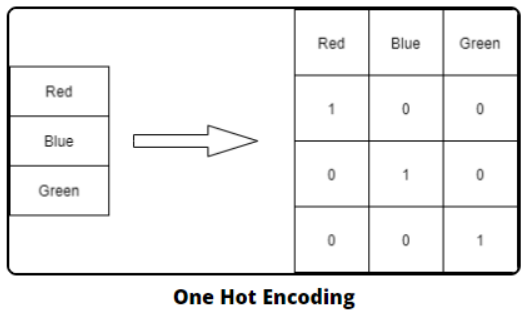
Red, Blue, Green처럼 순서가 없는 범주를 각각 독립된 0과 1의 컬럼으로 변환하는 방법이다.
특정 행이 해당 범주에 속하면 1, 속하지 않으면 0으로 표시한다.
전처리할 때는 학습 데이터에 fit_transform()을 사용하고,
테스트 데이터에는 학습된 인코더의 transform()만 사용해야 한다.
범주 사이에 임의의 순서가 생기지 않아 명목형 데이터에 적합하다.
다만 범주의 종류가 많으면 생성되는 컬럼 수도 크게 늘어나며, 대부분의 값이 0인 희소한 데이터가 만들어진다.
-> 따라서 성별이나 지역처럼 범주 수가 감당 가능한 데이터에 사용하는 것이 좋다.
2) Mean Encoding
group_mean = df.groupby('Pincode')['O/P'].mean()
df['Mean'] = df['Pincode'].map(group_mean)
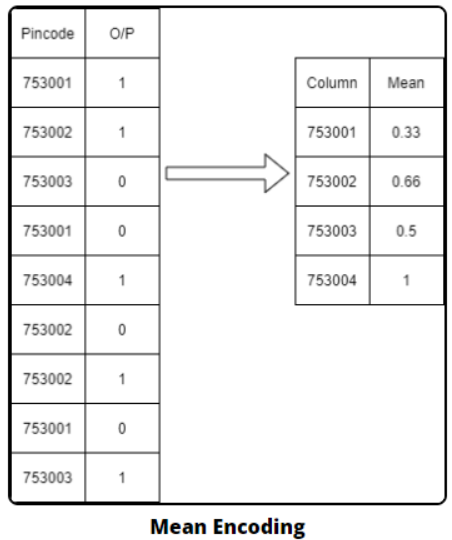
Mean Encoding은 각 범주를 해당 범주의 타겟 평균값으로 바꾸는 방법이다.
예를 들어 753001의 타겟값이 1, 0, 0이라면 평균인 0.33으로 변환하고,
753002의 타겟값이 1, 1, 0이라면 평균인 0.67로 변환한다.
원-핫 인코딩처럼 범주마다 새로운 컬럼을 만들지 않기 때문에 범주가 많아도 컬럼 수가 크게 증가하지 않는다.
하지만 정답인 타겟값을 이용하므로 전체 데이터에서 평균을 계산하면 데이터 누수와 과적합이 발생할 수 있다.
따라서 학습 데이터에서만 범주별 평균을 계산하고, 같은 값을 테스트 데이터에 적용해야 한다.
3) Label Encoding
from sklearn.preprocessing import LabelEncoder
encoder = LabelEncoder()
df['column_encoded'] = encoder.fit_transform(df['column'])
encoder.classes_
encoder.inverse_transform([0, 1])
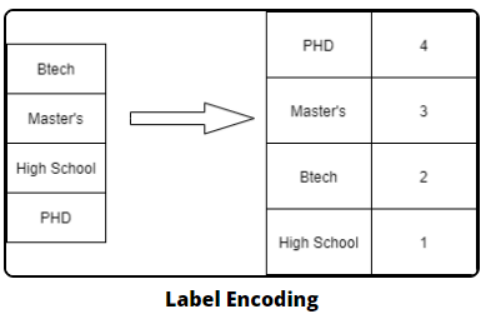
범주마다 정수 번호를 붙이는 방법으로, 주로 정답 데이터 y를 숫자로 바꿀 때 사용한다.
예를 들어 사망, 생존을 0, 1로 변환한다. classes_로 숫자가 어떤 범주와 연결됐는지 확인하고, inverse_transform()으로 숫자를 원래 범주로 되돌릴 수 있다.
단, 숫자는 단순한 라벨일 뿐 크기나 순서를 의미하지 않는다.
따라서 순서가 없는 입력 Feature에 사용하면 모델이 숫자 사이에 순서가 있다고 오해할 수 있다.
4) Ordinal Encoding
encoder = ce.OrdinalEncoder(cols='color')
df_encoded = encoder.fit_transform(df)
df_encoded.head()
Ordinal Encoding은 입력 데이터 X의 순서가 있는 범주를 정수로 변환하는 방법이다.
하 → 중 → 상처럼 실제 순서를 직접 지정하면 숫자의 크기에도 의미가 생긴다.
반면 색상처럼 순서가 없는 데이터에 자동 번호를 붙이면 숫자는 단순한 범주 코드일 뿐이며,
모델이 잘못된 순서 관계를 학습할 수 있으므로 One-Hot Encoding이 더 적합하다.
select_dtypes()는 실제 의미가 아니라 저장된 자료형을 기준으로 컬럼을 나눈다. 따라서 pclass, sibsp, parch처럼 숫자로 저장됐지만 범주로 처리할 컬럼은 직접 지정해야 한다.
5) Target Encoding
encoder = ce.TargetEncoder()
df_encoded = encoder.fit_transform(df['Column'], df['O/P'])
df['encoded'] = df_encoded['Column']
실행 결과
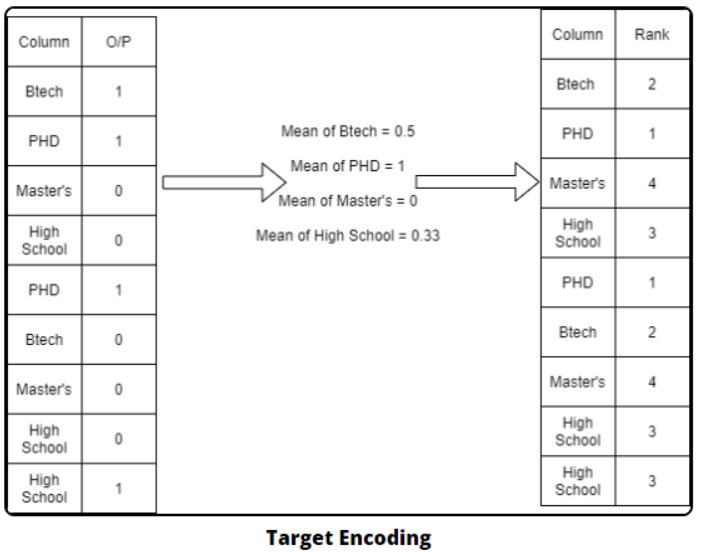
PHD 0.523251 / Btech 0.452325 / High School 0.427282 / Masters 0.381400
Target Encoding은 각 범주를 해당 범주의 타겟값을 바탕으로 계산한 숫자로 변환하는 방법이다.
Mean Encoding처럼 범주별 타겟 평균을 사용하지만, TargetEncoder는 전체 평균과 범주별 데이터 수를 함께 고려하여 값이 지나치게 치우치지 않도록 보정할 수 있다.
원-핫 인코딩처럼 컬럼 수가 늘어나지 않아 고유 범주가 많은 데이터에 유용하지만, 정답을 이용하는 방식이므로 학습 데이터에만 fit_transform()을 사용하고 테스트 데이터에는 transform()만 사용해야 한다.
3. 학습·테스트 데이터 분리
from sklearn.model_selection import train_test_split
X = df.drop('survived', axis=1)
y = df['survived']
X_tr, X_te, y_tr, y_te = train_test_split(
X, y, test_size=0.2, random_state=SEED, stratify=y
)
X_tr = X_tr.reset_index(drop=True)
X_te = X_te.reset_index(drop=True)
결과 확인: 강의자료 Titanic 기준으로 전체 891행은 학습 712행, 테스트 179행으로 나뉜다.
전처리 규칙은 X_tr에서만 학습한다.
6. 숫자형/범주형 컬럼 분리
X_tr_num = X_tr.select_dtypes(include='number')
X_tr_cat = X_tr.select_dtypes(exclude='number')
X_te_num = X_te.select_dtypes(include='number')
X_te_cat = X_te.select_dtypes(exclude='number')
결과 확인: 숫자형에는 스케일링 같은 처리를, 범주형에는 인코딩을 따로 적용할 수 있다.
assert X_tr.shape[1] == X_tr_num.shape[1] + X_tr_cat.shape[1]
assert X_te.shape[1] == X_te_num.shape[1] + X_te_cat.shape[1]
assert list(X_tr.columns) == list(X_te.columns)
결과 확인: 원본 컬럼 수가 숫자형과 범주형 컬럼 수의 합과 같고, 학습·테스트 컬럼 구성이 같은지 확인한다.
강의에서 강조한 습관 전처리 코드를 작성할 때는 결과를 눈으로만 보지 말고 shape, 컬럼 수, 결측치 수 같은 검증 코드를 함께 둔다.
7. category_encoders로 원-핫 인코딩
import category_encoders as ce
encoder = ce.OneHotEncoder(
cols=list(X_tr_cat.columns),
use_cat_names=True,
handle_unknown='value',
handle_missing='value'
)
X_tr_cat_encoded = encoder.fit_transform(X_tr_cat)
X_te_cat_encoded = encoder.transform(X_te_cat)
결과 확인: 학습 범주형 데이터로 범주 목록과 출력 컬럼을 학습한 뒤, 테스트에는 같은 규칙을 적용한다.
use_cat_names=True이면 원래 범주 이름이 컬럼명에 반영되어 해석하기 쉽다.
절대 금지 X_te에 fit 또는 fit_transform을 사용하지 않는다. 테스트 데이터의 정보를 전처리 규칙에 반영하면 데이터 누수가 발생한다.
8. 숫자형 데이터와 다시 합치기
X_tr_clean = pd.concat(
[X_tr_num.reset_index(drop=True),
+ X_tr_cat_encoded.reset_index(drop=True)],
+ axis=1
+)
X_te_clean = pd.concat(
[X_te_num.reset_index(drop=True),
+ X_te_cat_encoded.reset_index(drop=True)],
+ axis=1
+)
결과 확인: axis=1은 컬럼 방향으로 합친다는 뜻이다. 행 인덱스가 어긋나지 않도록 reset_index(drop=True)로 맞춘 뒤 결합한다.
print(X_tr_clean.shape, X_te_clean.shape)
print(X_tr_clean.isna().sum().sum())
print(X_te_clean.isna().sum().sum())
assert list(X_tr_clean.columns) == list(X_te_clean.columns)
결과 확인: 학습·테스트의 컬럼 수와 순서가 같고, 예상하지 못한 결측치가 없는지 확인한다.
9. 반복 작업 -> 함수로 묶기
def one_hot_encode(X_tr, X_te):
tr_num = X_tr.select_dtypes(include='number').reset_index(drop=True)
te_num = X_te.select_dtypes(include='number').reset_index(drop=True)
tr_cat = X_tr.select_dtypes(exclude='number').reset_index(drop=True)
te_cat = X_te.select_dtypes(exclude='number').reset_index(drop=True)
encoder = ce.OneHotEncoder(
cols=list(tr_cat.columns), use_cat_names=True,
handle_unknown='value', handle_missing='value'
)
tr_encoded = encoder.fit_transform(tr_cat)
te_encoded = encoder.transform(te_cat)
tr_result = pd.concat([tr_num, tr_encoded], axis=1)
te_result = pd.concat([te_num, te_encoded], axis=1)
assert list(tr_result.columns) == list(te_result.columns)
return tr_result, te_result, encoder
결과 확인: 한 컬럼에서 확인한 작업을 모든 범주형 컬럼에 재사용할 수 있다.
반환값으로 학습·테스트 결과와 encoder를 함께 보관하면 이후 새 데이터에도 같은 변환을 적용할 수 있다.
10. 학습 데이터로 fit, 테스트는 transform만 한다
enco_tr = pd.DataFrame()
enco_te = pd.DataFrame()
for col in tmp_tr.columns:
_enco = encoder.fit_transform(tmp_tr[col].astype('category'))
enco_tr = pd.concat([enco_tr, _enco], axis=1)
_enco = encoder.transform(tmp_te[col].astype('category'))
enco_te = pd.concat([enco_te, _enco], axis=1)
print(f'{enco_tr.shape} / {enco_te.shape}')
실행 결과
(712, 22) / (179, 22)
train은 fit_transform(), test는 transform()만 사용한다.
테스트 데이터로 인코더를 다시 학습하면 평가 전에 테스트 정보를 본 것이 되어 데이터 누수가 발생한다.
11. 주의
- 타겟 y는 피처 인코딩 대상에 넣지 않는다.
- 학습 데이터에서만 fit하고 테스트 데이터에는 transform만 한다.
- 원-핫 인코딩 전 결측값과 고유 범주 수를 확인한다.
- 숫자로 저장된 범주형은 select_dtypes만으로 구분되지 않으므로 의미를 보고 별도로 지정한다.
- pd.concat(axis=1) 전에 인덱스를 맞춘다.
- 학습·테스트의 최종 컬럼 이름과 순서가 같은지 assert로 검증한다.
- Mean/Target Encoding은 타겟 누수 방지를 위해 교차검증 내부에서 적용한다.
학습·테스트 분리 → 데이터 유형 확인 → 학습 데이터로 인코더 fit → 학습·테스트 transform → 숫자형과 결합
→ shape·컬럼·결측치 검증. 누수가 없는 기준선을 만든 뒤 범주 수와 모델 특성에 따라 여러 인코딩 방법을 비교
'개발 공부 > 머신러닝' 카테고리의 다른 글
| [Machine Learning] One-Hot Encoding 정리 | Train/Test 전처리 (2) | 2026.09.05 |
|---|---|
| [Machine Learning] One-Hot Encoding 정리 (0) | 2026.09.04 |
| [Machine Learning] 인공지능·머신러닝·딥러닝과 학습 종류 정리 (0) | 2026.09.03 |
| [Machine Learning] 데이터 누수란? (0) | 2026.09.03 |
| [Machine Learning] 전체 워크플로우와 유방암 데이터 탐색하기 (0) | 2026.09.03 |
