1. 인공지능과 머신러닝은 같은 말이 아니다
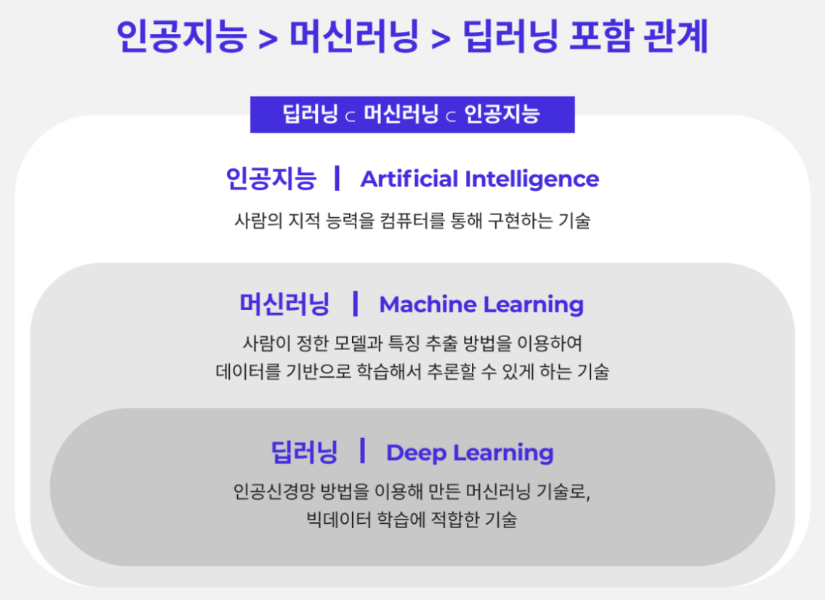
인공지능(AI)은 사람이 하는 사고·학습·판단을 컴퓨터가 수행하도록 연구하는 가장 넓은 분야다.
머신러닝 : 사람이 모든 규칙을 직접 코딩하지 않고 데이터에서 규칙을 학습하게 하는 AI의 한 분야
딥러닝 : 인공신경망을 여러 층으로 쌓아 학습하는 머신러닝의 하위 분야
2. 머신러닝은 손실을 줄이는 파라미터를 찾는다
모델은 입력 데이터로 예측을 만들고 정답과의 차이를 손실(Loss)로 계산한다. 학습은 이 손실이 작아지도록 모델 내부의 파라미터를 반복해서 조정하는 과정이다.
- Parameter: 모델이 학습 과정에서 스스로 업데이트하는 값
- Hyperparameter: 사용자가 학습 전에 직접 정하는 설정값
- Loss: 정답과 예측의 오차를 나타내는 값
- Metric: 학습된 모델의 성능을 판단하는 평가 지표
3. 머신러닝의 세 가지 학습 방식
1) 지도학습
입력값인 Feature와 정답인 Target을 함께 주고 학습한다.
- 분류(Classification): 생존/사망, 악성/양성처럼 정해진 범주를 예측한다.
- 회귀(Regression): 집값이나 매출처럼 연속적인 숫자를 예측한다.
2) 비지도학습
정답 없이 Feature만 제공하고 데이터 안의 구조나 패턴을 찾는다.
- 군집: 비슷한 데이터를 그룹으로 묶는다.
- 차원 축소: 중요한 정보는 유지하면서 변수 수를 줄인다.
- 연관 규칙: 함께 나타나는 항목 사이의 관계를 찾는다.
3) 강화학습
행동의 결과에 보상이나 벌점을 주고, 누적 보상이 커지는 방향으로 학습한다.
4. 머신러닝 프로젝트의 전체 흐름
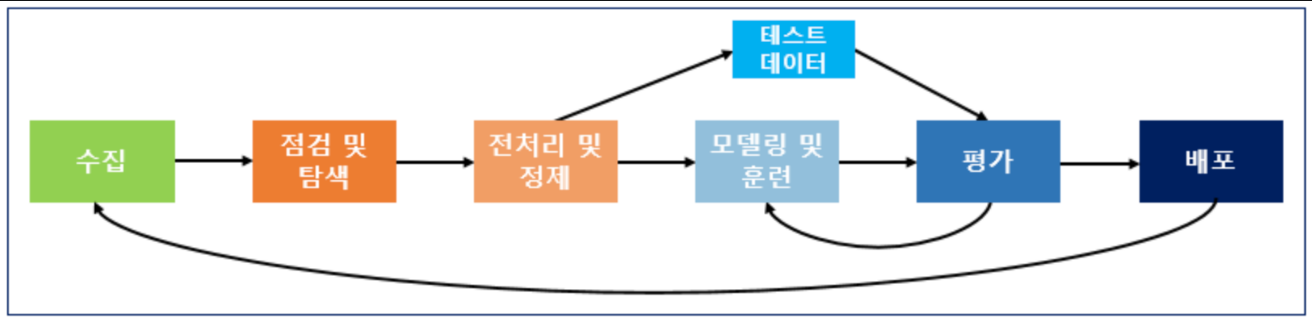
- 수집: 모델 학습에 필요한 Feature와 Target을 모음
- 점검·탐색: 구조, 결측치, 이상치와 분포를 EDA로 확인
- 전처리·정제: 결측값 처리, 인코딩, 스케일링 등 학습 가능한 형태로 바꿈
- 모델링·훈련: 알고리즘을 선택하고 학습 데이터로 파라미터를 학습
- 평가: 테스트 데이터와 적절한 Metric으로 일반화 성능을 확인
- 배포: 충분한 성능을 확인한 모델을 실제 서비스에 적용
핵심: Feature는 문제를 설명하는 입력값, Target은 모델이 맞혀야 할 정답
모델 학습은 Loss를 줄이는 Parameter를 찾는 과정
반응형
'개발 공부 > 머신러닝' 카테고리의 다른 글
| [Machine Learning] One-Hot Encoding 정리 | Train/Test 전처리 (2) | 2026.09.05 |
|---|---|
| [Machine Learning] One-Hot Encoding 정리 (0) | 2026.09.04 |
| [Machine Learning] 데이터 누수란? (0) | 2026.09.03 |
| [Machine Learning] 범주형 데이터 인코딩과 학습·테스트 전처리 (0) | 2026.09.03 |
| [Machine Learning] 전체 워크플로우와 유방암 데이터 탐색하기 (0) | 2026.09.03 |