1. One-Hot Encoding
범주 하나마다 별도의 컬럼을 만들고, 해당 범주이면 1 아니면 0으로 표현하는 방식이다.
순서 정보가 없는 범주형 데이터에 대표적으로 사용한다.
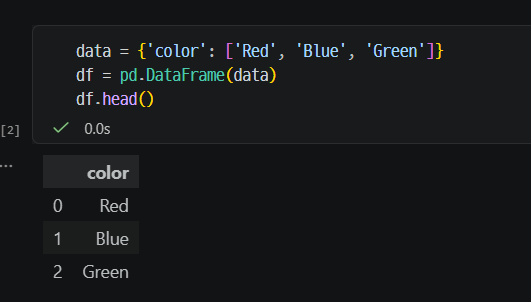
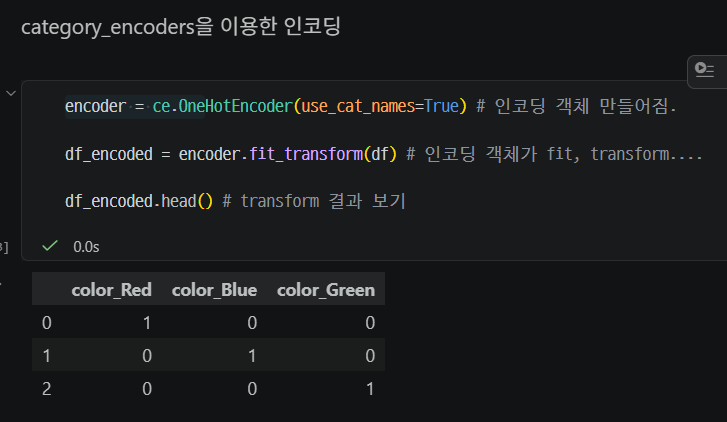
| encoder = ce.OneHotEncoder(use_cat_names=True) df_encoded = encoder.fit_transform(df) df_encoded.head() |
use_cat_names=True를 사용하면 color_Red, color_Blue처럼 실제 범주명이 인코딩된 컬럼명에 반영되어 결과를 쉽게 확인할 수 있다.
범주의 종류가 많을수록 생성되는 컬럼 수도 많아진다. 이 경우 차원의 저주에 빠질 수 있다.
=> 차원이 너무 커지면서 데이터가 희소해지고, 학습에 필요한 데이터가 급격히 많아지는 문제.
⠀
2. train / test 처리⭐
인코딩에서 가장 중요한 것은 Train에서 학습한 인코딩 규칙을 Test에도 그대로 적용하는 것이다.
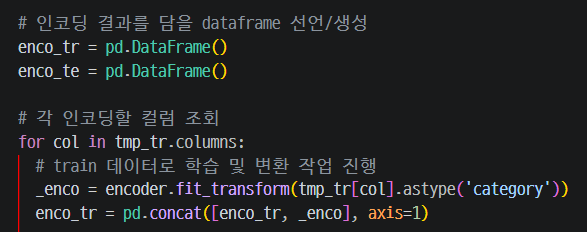
Train 데이터에서는 fit_transform()을 사용한다.
fit : 인코딩 규칙 학습
transform : 학습한 규칙으로 데이터 변환
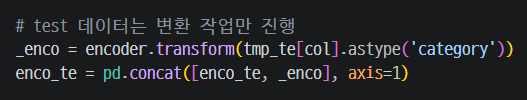
Test 데이터에서는 fit()을 다시 하지 않고, Train에서 학습한 규칙을 이용해 transform()만 수행한다.
⠀
❗ 데이터누수 주의
Test 데이터에 다시 fit() 또는 fit_transform()을 사용하면
Test 정보가 학습 과정에 포함되어 데이터 누수(Data Leakage)가 발생할 수 있다.
⠀
3. EncodingType 코드 해석
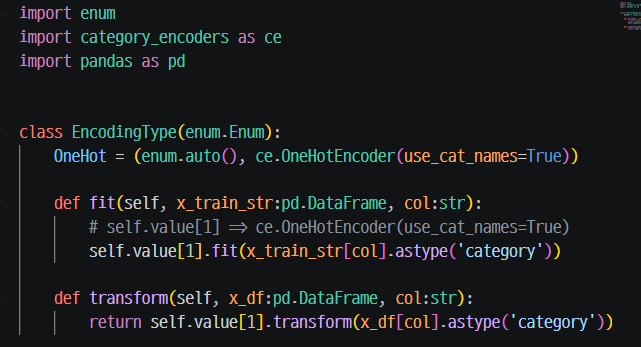
EncodingType을 Enum으로 만들어 사용할 인코딩 방식과 실제 인코더 객체를 함께 관리한다.
| 코드 | 의미 |
| OneHot = (...) | 식별값 + 인코더 객체를 하나로 저장 |
| enum.auto() | Enum 멤버를 구분하기 위한 자동 식별값 |
| self.value[0] | 첫 번째 값 → 식별값 |
| self.value[1] | 두 번째 값 → 실제 OneHotEncoder 객체 |
| astype('category') | 해당 컬럼을 category 타입으로 변환 |
⠀
특히,
self.value[1].fit(...)에서 self.value[1]은 실제 OneHotEncoder 객체이다.
따라서 위 코드는
저장해 둔 OneHotEncoder 객체에 fit()을 실행한다.
는 의미다.
⠀
왜 tuple을 사용했을까?
OneHot = (enum.auto(), ce.OneHotEncoder(use_cat_names=True))OneHot 하나에 식별값과 실제 인코더 객체를 한 세트로 묶어 저장하기 위해 tuple을 사용했다.
- list : 값의 추가·삭제·변경이 필요한 목록
- dict : 각 값에 key 이름을 붙여 관리할 때
- tuple : 정해진 값들을 고정된 한 묶음으로 관리할 때
⠀
4. transform_encoding()⠀

① 입력값 검증
assert encoding_type in EncodingType전달받은 encoding_type이 EncodingType에 정의된 값인지 확인한다. ⠀
② 결과를 저장할 빈 DataFrame 생성
x_train_enc = pd.DataFrame()
x_test_enc = pd.DataFrame()
컬럼별 인코딩 결과를 차곡차곡 누적하기 위한 빈 저장 공간을 만든다.
⠀
③ 비숫자형 컬럼을 하나씩 순회
for col in x_train_str.columns:x_train_str의 컬럼명을 하나씩 col에 넣으며 반복한다.
⠀
④ Train 데이터로 학습
encoding_type.fit(x_train_str, col)현재 Train 컬럼을 이용해 인코딩 규칙을 학습한다.
⠀
⑤ Train / Test 변환
encoded_col = encoding_type.transform(x_train_str, col)
encoded_col_test = encoding_type.transform(x_test_str, col)
Train에서 학습한 같은 인코더를 이용해 Train과 Test를 각각 변환한다. ⠀
⑥ 인코딩 결과를 오른쪽으로 추가
x_train_enc = pd.concat(
    [x_train_enc, encoded_col], axis=1
)
x_test_enc = pd.concat(
	[x_test_enc, encoded_col_test], axis=1
)
axis=1이므로 인코딩 결과를 행이 아닌 컬럼 방향으로 붙인다.
빈 DataFrame
     ↓
첫 번째 컬럼 인코딩 → 추가
     ↓
두 번째 컬럼 인코딩 → 추가
     ↓
세 번째 컬럼 인코딩 → 추가
     ↓
최종 인코딩 DataFrame
⠀
⑦ 최종 결과 반환
return x_train_enc, x_test_enc모든 컬럼의 인코딩이 끝나면 완성된 Train/Test DataFrame을 반환한다.
'개발 공부 > 머신러닝' 카테고리의 다른 글
| [Machine Learning] 회귀 평가지표 7가지 | R², MSE, RMSE, RMSLE, MAE, MAPE, SMAPE (0) | 2026.09.05 |
|---|---|
| [Machine Learning] 데이터 스케일링 | StandardScaler, MinMaxScaler (1) | 2026.09.05 |
| [Machine Learning] One-Hot Encoding 정리 (0) | 2026.09.04 |
| [Machine Learning] 인공지능·머신러닝·딥러닝과 학습 종류 정리 (0) | 2026.09.03 |
| [Machine Learning] 데이터 누수란? (0) | 2026.09.03 |


