1. 신경망은 무엇을 쌓은 구조일까
신경망의 기본 연산은 여러 입력에 Weight를 곱하고 Bias를 더하는 선형 연산이다.
여기에 ReLU 같은 Activation Function을 적용하면 단순한 직선 관계만이 아니라 복잡한 비선형 패턴을 표현할 수 있다.
y = f(b + w1*x1 + w2*x2 + ... + wn*xn)
| 기호 | 의미 |
| x | 입력 feature |
| w | 각 입력이 결과에 미치는 영향인 Weight |
| b | 기준점을 이동시키는 Bias |
| f | 비선형성을 더하는 Activation Function |
⠀
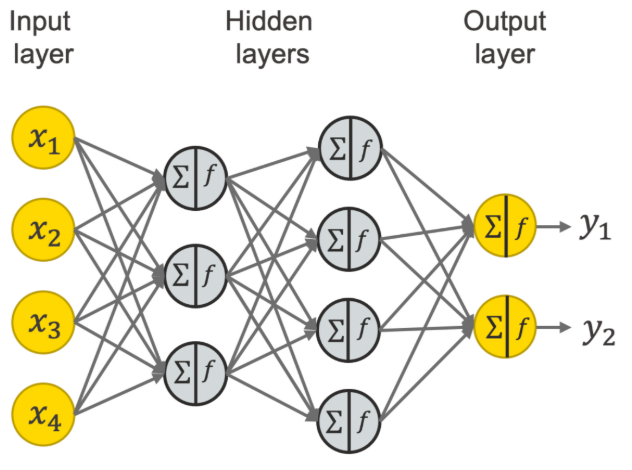
그림을 볼 때는 Layer별 입력과 출력부터 읽는다
한 Layer의 출력 개수는 다음 Layer의 입력 개수가 된다.
첫 Layer는 feature 개수의 영향을 받고, 마지막 Layer는 target 클래스 개수의 영향을 받는다.
그 사이 Hidden Layer의 크기는 모델 설계자가 정할 수 있다.
| 위치 | input size | output size |
| 첫 Layer | feature size | hidden size |
| 중간 Layer | 이전 Layer의 output | 다음 hidden size |
| 마지막 Layer | 이전 Layer의 output | target size |
📌 이해 보충 | FashionMNIST는 28×28 흑백 이미지이므로 한 장을 펼치면 feature size는 `1×28×28=784`다.
클래스가 10개이므로 마지막 output size는 10이어야 한다.
⠀
2. PyTorch 모델 클래스에 필요한 두 메서드
from torch import nn
class NeuralNetwork(nn.Module):
def __init__(self):
super().__init__()
# 사용할 Layer를 준비
def forward(self, features):
# features가 Layer를 통과하는 순서를 정의
return prediction
| 메서드 | 역할 |
| __init__ | Layer와 모델 구성 요소를 객체 변수로 준비 |
| forward | 입력 feature가 각 Layer를 통과하는 계산 순서를 정의 |
`nn.Module`을 상속하면 PyTorch가 모델의 Parameter를 추적하고 CPU와 GPU 이동, 저장, 학습 모드 전환 같은 기능을 사용할 수 있다. `super().__init__()`은 부모 클래스인 `nn.Module`을 초기화하는 코드다.
📌 이해 보충 | 모델을 사용할 때 `model(features)`처럼 호출하면 PyTorch가 내부적으로 `forward(features)`를 실행한다. 따라서 보통 `model.forward(features)`를 직접 호출하지 않는다.
⠀
Model과 입력 Tensor는 같은 Device에 둔다
device = "cuda" if torch.cuda.is_available() else "cpu"
model = NeuralNetwork().to(device)
features = features.to(device)
GPU 모델의 Weight는 GPU 메모리에 있고 CPU Tensor는 CPU 메모리에 있다.
서로 다른 메모리에 있는 값은 바로 행렬곱을 할 수 없으므로 모델과 입력을 모두 같은 Device로 이동해야 한다.
⠀
3. 이미지가 Linear Layer에 들어가기 전에 Flatten이 필요한 이유
이미지 Batch의 Shape은 보통 `(B, C, H, W)`지만 `nn.Linear`는 한 샘플을 길이 하나인 Vector로 받는다.
따라서 Batch 차원은 유지하고 나머지 차원을 펼친다.
features.shape
# (10, 1, 28, 28)
flatten = nn.Flatten()
out = flatten(features)
out.shape
# (10, 784)
📌 이해 보충 | `10`은 Batch 크기이므로 유지된다.
한 이미지의 `1×28×28`만 곱해져 784가 된다.
전체 원소 수는 `10×1×28×28 = 10×784`로 그대로다.
📌 이해 보충 | `nn.Flatten()`의 기본값은 `start_dim=1`이다.
0번 차원인 Batch는 그대로 두고 1번 차원부터 마지막 차원까지만 펼치기 때문에 이미지 10장이 한 덩어리로 섞이지 않는다.
⠀
4. Linear와 ReLU는 Shape에 어떤 영향을 줄까
linear = nn.Linear(in_features=784, out_features=512)
out = linear(flattened_features)
# (batch, 512)
relu = nn.ReLU()
activated = relu(out)
# (batch, 512)
| Layer | 값 변화 | Shape 변화 |
| nn.Linear | Weight와 Bias로 선형 계산 | out_features에 맞춰 바뀜 |
| nn.ReLU | 음수는 0, 양수는 유지 | 바뀌지 않음 |
`nn.Linear(784, 512)`의 512는 첫 Hidden Layer에 있는 출력 뉴런 수다.
다음 Linear Layer는 이 512개 값을 입력으로 받아야 하므로 `nn.Linear(512, ...)`로 연결한다.
⠀
Weight와 Bias Shape은 왜 이렇게 생길까
layer = nn.Linear(in_features=784, out_features=512)
layer.weight.shape
# torch.Size([512, 784])
layer.bias.shape
# torch.Size([512])
출력값 512개는 각각 입력값 784개를 모두 사용해 계산된다.
따라서 Weight는 `출력 개수 × 입력 개수`, 즉 `(512, 784)`이고,
출력 뉴런마다 Bias가 하나씩 필요하므로 Bias는 `(512,)`다.
| Parameter | Shape | 의미 |
| Weight | (512, 784) | 512개 출력마다 784개 입력 Weight |
| Bias | (512,) | 512개 출력마다 Bias 1개 |
⠀
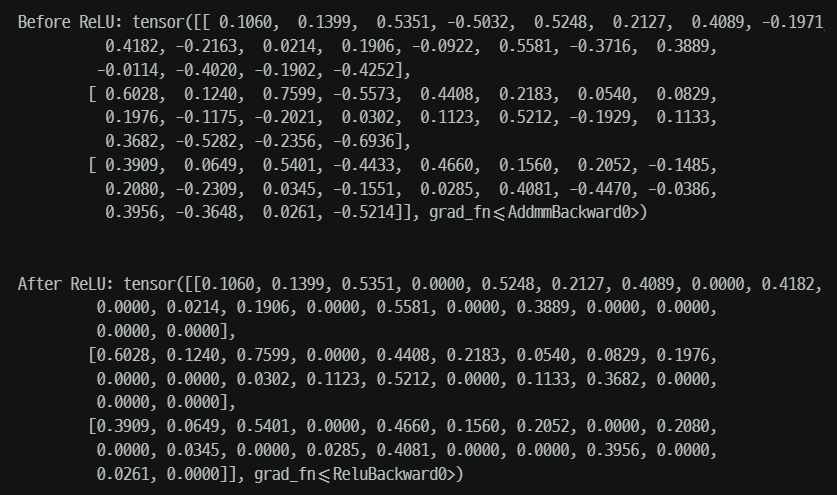
ReLU는 값을 바꾸지만 Shape은 바꾸지 않는다
| Linear 출력 | ReLU 출력 |
| 0.2826 | 0.2826 |
| -0.4782 | 0 |
| -0.0358 | 0 |
| 0.4889 | 0.4889 |
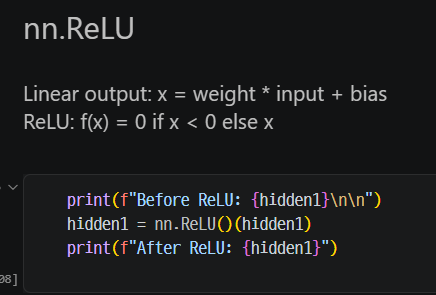
ReLU는 음수를 0으로 바꾸고 양수는 그대로 둔다.
값은 달라지지만 원소를 추가하거나 삭제하지 않으므로 `(batch, 512)`라는 Shape은 유지된다.
⠀
5. Model V1은 계산 과정을 한 단계씩 보여준다
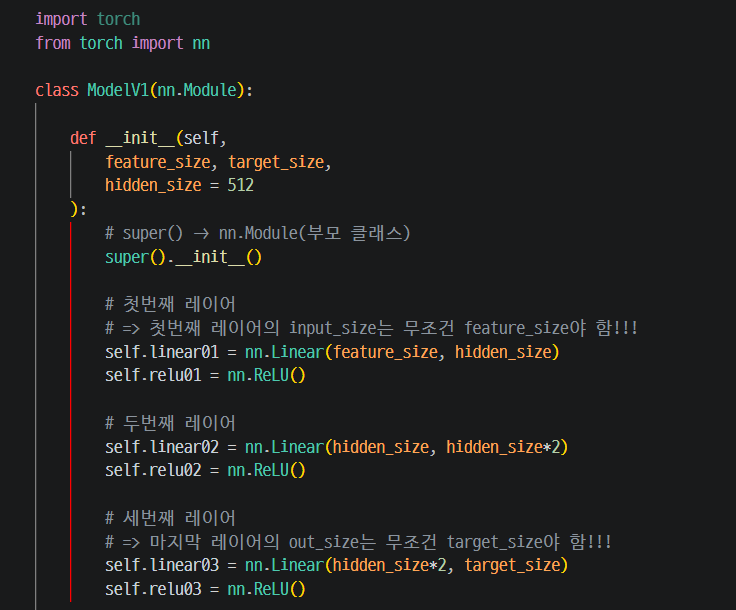
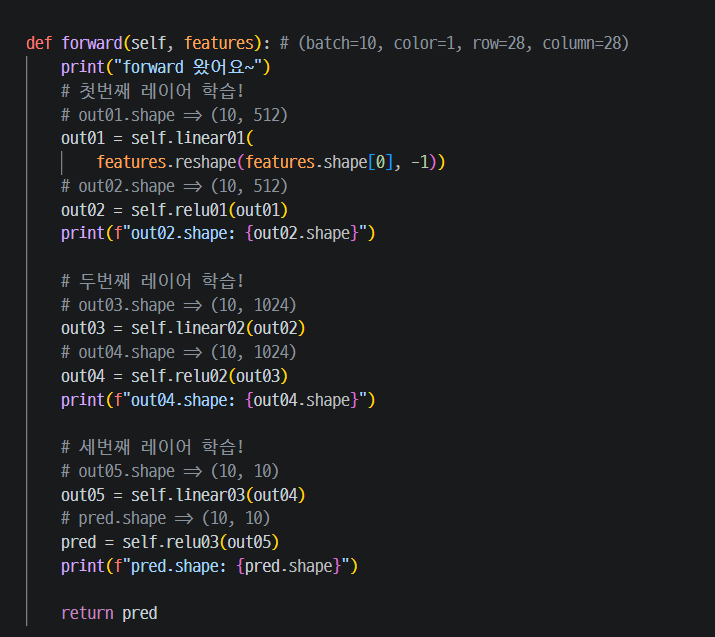
V1은 각 중간 결과를 변수로 저장하므로 Shape이 어떻게 변하는지 따라가기 쉽다.
대신 Layer가 많아지면 변수와 코드가 빠르게 늘어난다.
⠀
실행 결과
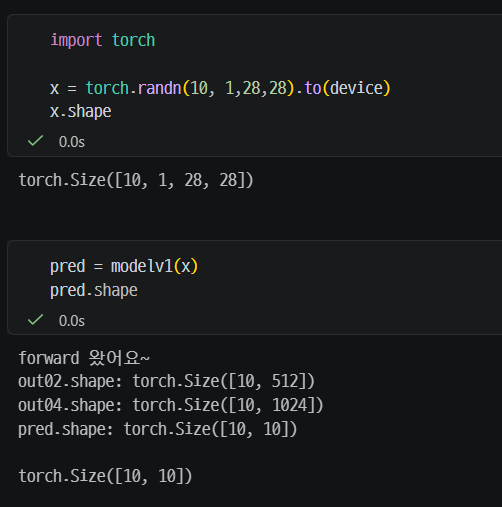
| 단계 | Shape | 해석 |
| 입력 | (10, 1, 28, 28) | 28×28 이미지 10장 |
| Flatten 후 첫 Layer | (10, 512) | 이미지마다 512개 출력 |
| 두 번째 Layer | (10, 1024) | 이미지마다 1024개 출력 |
| 마지막 Layer | (10, 10) | 이미지마다 클래스 10개 점수 |
6. 핵심 정리
| 코드 | 역할 |
| nn.Module | PyTorch 모델의 부모 클래스 |
| __init__ | Layer를 생성하고 저장 |
| forward | 입력이 통과할 계산 순서 정의 |
| nn.Flatten | Batch를 유지하고 이미지 차원을 Vector로 펼침 |
| nn.Linear | 입력과 출력 크기를 바꾸는 선형 계산 |
| nn.ReLU | 음수를 0으로 바꾸어 비선형성 추가 |
| .to(device) | 모델과 데이터를 같은 연산 장치로 이동 |
모델을 만들 때 마음대로 정할 수 없는 것은 첫 Layer의 입력 크기와 마지막 Layer의 출력 크기다.
중간 Hidden Layer의 크기는 설계할 수 있지만, 앞 Layer의 출력이 다음 Layer의 입력과 정확히 이어져야 한다.
'개발 공부 > 딥러닝' 카테고리의 다른 글
| [Deep Learning] PyTorch 모델 학습의 전체 흐름 | Loss, Optimizer, Training Loop와 모델 저장 (0) | 2026.09.26 |
|---|---|
| [Deep Learning] PyTorch 모델 구조를 단순화하고 예측값 해석하기 (0) | 2026.09.26 |
| [Deep Learning] 시계열 Dataset에 MinMax Scaling 적용하기 (0) | 2026.09.26 |
| [Deep Learning] 표 데이터와 시계열 데이터도 Dataset으로 만들기 (0) | 2026.09.25 |
| [Deep Learning] PyTorch Custom Dataset 만들기 (0) | 2026.09.25 |