1. 왜 Model V2가 필요한가
V1은 이해하기 쉽지만 Linear와 ReLU를 하나씩 호출해야 한다.
실제 신경망은 Layer가 많아질 수 있으므로 순서가 정해진 연산을 `nn.Sequential` 하나로 묶으면 코드와 실수를 함께 줄일 수 있다.
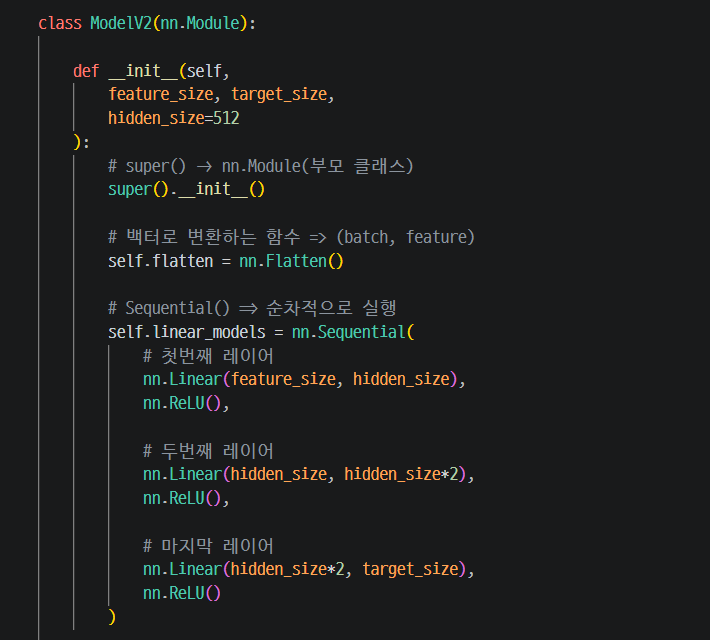

Sequential 내부의 0번부터 5번 모듈이 적힌 순서대로 실행된다.
입력과 출력 Shape은 V1과 같지만 중간 변수를 일일이 만들지 않아도 된다.
| Sequential 인덱스 | 모듈 | 출력 Shape |
| 0 | Linear 784 → 512 | (batch, 512) |
| 1 | ReLU | (batch, 512) |
| 2 | Linear 512 → 1024 | (batch, 1024) |
| 3 | ReLU | (batch, 1024) |
| 4 | Linear 1024 → 10 | (batch, 10) |
📌 이해 보충 | 마지막 Layer에는 왜 ReLU를 사용하지 않을까?
중간 Layer에서는 비선형성을 주기 위해 ReLU를 사용하지만, 마지막 출력은 클래스별 Logit이므로 값의 범위를 제한하지 않는다. 특히 CrossEntropyLoss는 Logit을 그대로 입력받기 때문에 마지막에 Softmax나 ReLU를 따로 적용하지 않는다. ⠀
⠀
2. Model V3는 기능별 모델을 다시 조합한다
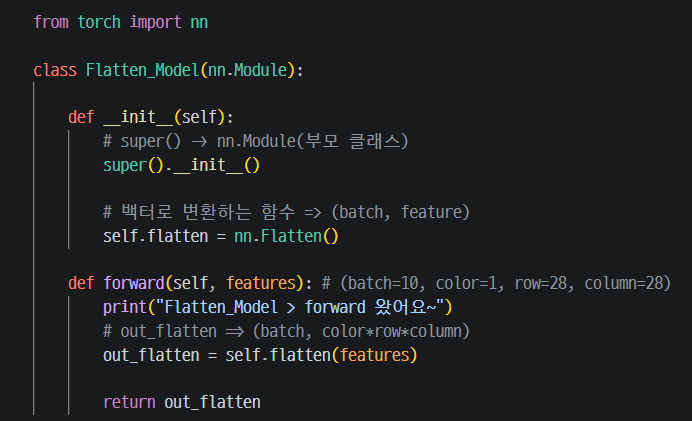
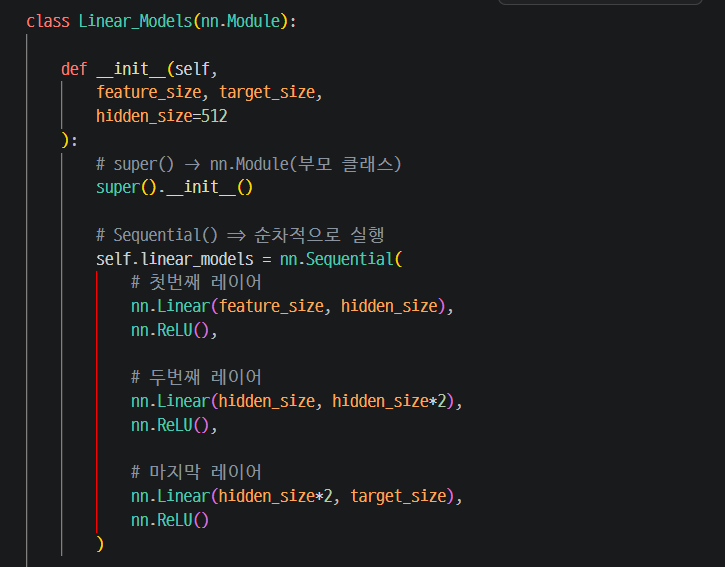
모델이 더 복잡해지면 Flatten 기능과 Linear Stack을 각각 독립된 클래스로 나누고, 최종 모델에서 두 클래스를 조합할 수 있다. 각 부분을 따로 테스트하고 재사용하기 쉬워지는 방식이다.
⠀
Flatten 전용 모델
⠀
Linear Stack 전용 모델
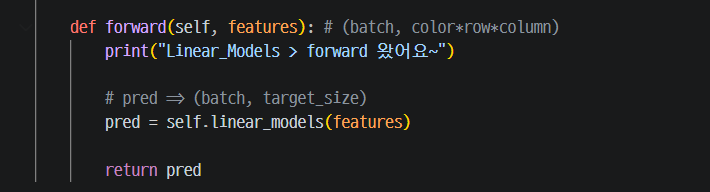
⠀
두 모델을 조합한 최종 Model V3
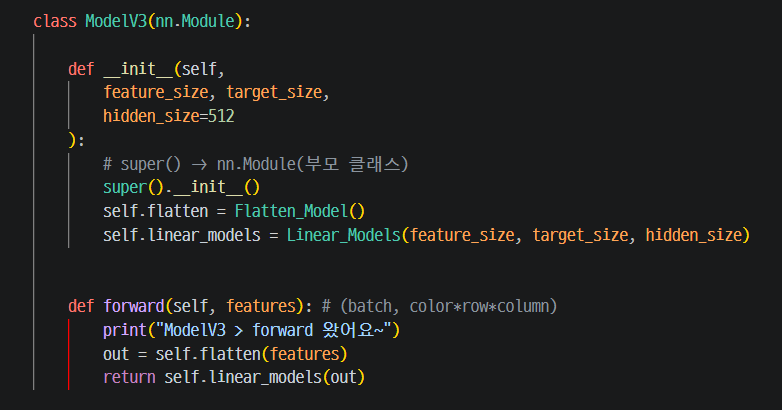
⠀
실행 순서 확인
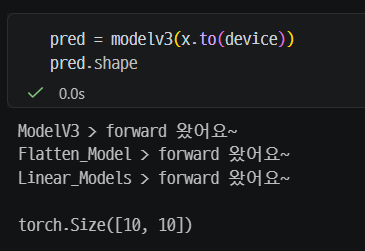
최종 모델의 `forward()`가 먼저 호출되고, 그 안에서 Flatten 모델과 Linear 모델이 차례로 호출된다.
이것이 큰 모델을 작은 모듈로 나눈 뒤 연결하는 기본 아이디어다.
Model V3 내부 모듈이 호출되는 순서와 최종 출력 Shape
| 버전 | 구조 | 장점 |
| V1 | Layer를 하나씩 호출 | Shape 흐름을 처음 이해하기 좋음 |
| V2 | Sequential로 묶음 | 짧고 실수가 적음 |
| V3 | 기능별 클래스를 조합 | 복잡한 모델의 재사용과 관리에 유리 |
⠀
3. 모델이 출력한 값은 아직 확률이 아니다
마지막 Layer가 반환한 10개 숫자는 각 클래스의 점수인 Logit이다.
숫자가 크면 해당 클래스를 더 강하게 선택했다는 뜻이지만, 합이 1인 확률은 아니다.
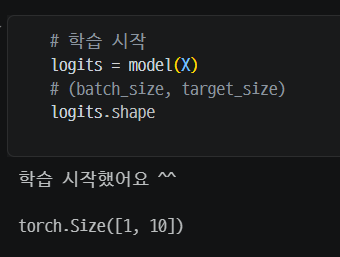
이미지 한 장에 대해 클래스가 10개이므로 `(1, 10)`이 나온다.
첫 번째 1은 Batch 크기, 두 번째 10은 클래스별 점수 개수다.
⠀
4. Softmax는 클래스 점수를 확률로 바꾼다
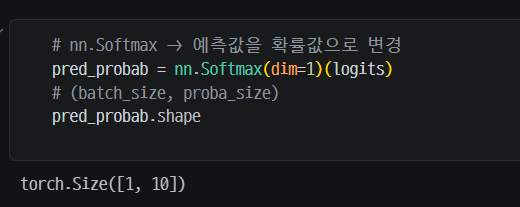
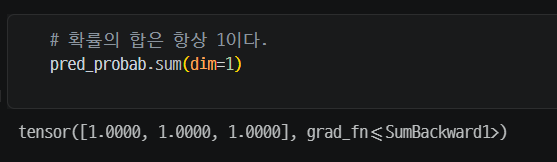
Softmax는 각 점수를 0과 1 사이로 바꾸고, 같은 샘플에 속한 클래스 확률의 합을 1로 만든다.
Shape은 바꾸지 않고 값의 의미만 점수에서 확률로 바꾼다.
📌 이해 보충 | 예를 들어 Logit이 `[2, 1, 0]`이면 Softmax 결과는 약 `[0.665, 0.245, 0.090]`이다.
가장 큰 점수 2가 가장 높은 확률이 되지만 다른 클래스의 가능성도 함께 남고, 세 확률의 합은 1이 된다.
📌 주의 | 학습할 때는 Softmax를 직접 적용하지 않는다.
nn.CrossEntropyLoss는 내부에서 LogSoftmax에 해당하는 연산을 처리하므로 모델의 출력인 Logit을 그대로 전달한다. Softmax는 학습 후 각 클래스의 예측 확률을 확인하고 싶을 때 사용한다.
⠀
왜 dim=1일까
| 차원 | 의미 | Softmax 적용 여부 |
| dim=0 | Batch 차원 | 서로 다른 샘플끼리 묶이므로 사용하지 않음 |
| dim=1 | 클래스 차원 | 한 샘플의 10개 클래스 점수를 확률로 변환 |
📌 이해 보충 | `dim=1`을 외우는 것이 아니라 Logit Shape을 먼저 읽어야 한다.
`(batch, class)`에서는 클래스가 1번 차원이므로 `dim=1`이다.
5. argmax로 최종 예측 클래스를 선택한다
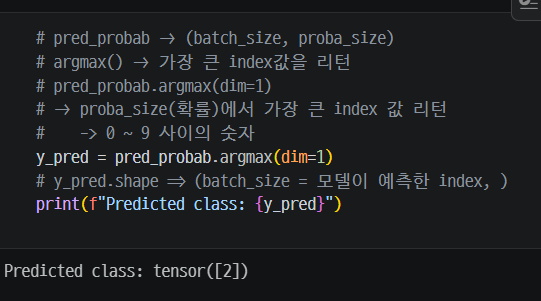
`argmax(dim=1)`은 각 샘플의 클래스 확률 중 가장 큰 값이 있는 위치를 반환한다.
결과 5는 확률이 5라는 뜻이 아니라, 0번부터 9번까지의 클래스 중 5번 클래스의 확률이 가장 높았다는 뜻이다.
📌 이해 보충 | Softmax는 점수의 순서를 바꾸지 않으므로 최종 클래스 번호만 필요하다면 `logits.argmax(dim=1)`로도 같은 인덱스를 얻는다. Softmax는 각 클래스의 확률까지 해석하고 싶을 때 필요하다.
| 단계 | Shape | 값의 의미 |
| Logits | (1, 10) | 클래스별 원시 점수 |
| Softmax | (1, 10) | 합이 1인 클래스별 확률 |
| argmax | (1,) | 가장 높은 확률의 클래스 인덱스 |
⠀
6. 핵심 정리
| 개념 | 기억할 내용 |
| Sequential | 등록된 Layer를 인덱스 순서대로 실행 |
| 모듈 분리 | 큰 모델을 기능별 클래스로 나눠 조합 |
| Logits | 확률로 변환되기 전 클래스별 점수 |
| Softmax | 클래스 점수를 합이 1인 확률로 변환 |
| argmax | 가장 큰 확률의 클래스 인덱스를 선택 |
V1, V2, V3는 서로 다른 계산을 하는 모델이 아니라 같은 신경망의 흐름을 서로 다른 방식으로 구현한 것이다.
V1에서 Layer와 Shape의 흐름을 직접 확인하고, V2에서 Sequential로 단순화한 뒤, V3에서는 기능별로 모듈을 분리해 다시 조합했다.
모델을 만드는 것에서 끝나는 것이 아니라 마지막 출력인 Logit → Softmax → argmax가 실제 분류 결과로 어떻게 이어지는지까지 같이 이해해두자.
'개발 공부 > 딥러닝' 카테고리의 다른 글
| [Deep Learning] PyTorch 이진분류 | BCEWithLogitsLoss, Sigmoid와 squeeze가 필요한 이유 (0) | 2026.09.26 |
|---|---|
| [Deep Learning] PyTorch 모델 학습의 전체 흐름 | Loss, Optimizer, Training Loop와 모델 저장 (0) | 2026.09.26 |
| [Deep Learning] PyTorch 신경망 모델 직접 만들기 (0) | 2026.09.26 |
| [Deep Learning] 시계열 Dataset에 MinMax Scaling 적용하기 (0) | 2026.09.26 |
| [Deep Learning] 표 데이터와 시계열 데이터도 Dataset으로 만들기 (0) | 2026.09.25 |