이전에는 선형회귀를 통해 모델이 예측값을 만들고,
Loss를 계산한 뒤 Gradient를 구해서 파라미터를 업데이트하는 기본적인 Training Loop를 살펴봤다.
이번에는 출력값이 연속적인 숫자가 아니라 0 또는 1 중 하나의 클래스를 예측하는 이진분류(Binary Classification)를 다뤘다.
이진분류에서는 단순히 모델의 출력값을 바로 0과 1로 비교하는 것이 아니라,
Logit → Sigmoid → Probability → Class
의 흐름으로 값을 해석하게 된다.
그리고 이 과정에서 Loss를 계산할 때와 실제 클래스 예측값을 만들 때 사용하는 값이 다르다는 점,
예측값과 정답의 Shape을 맞춰야 한다는 점이 중요했다.
⠀
1. Circle 데이터를 0과 1로 분류하기
ex11에서는 make_circles()를 이용해 만든 두 개의 원형 데이터를 분류했다.
각 데이터는 두 개의 Feature를 가지고 있고, 정답은 0 또는 1 두 개의 클래스로 구성되어 있다.
따라서 모델은
2개의 Feature 입력 → Hidden Layer → 1개의 출력값
을 가지는 구조로 시작했다.
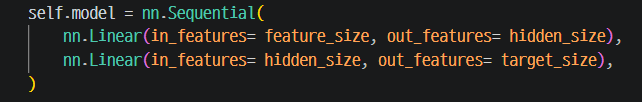
여기서 마지막 출력이 1개라고 해서 모델이 바로 0이나 1을 출력하는 것은 아니다.
모델이 실제로 출력하는 값은 Logit이다.
예를 들어 모델의 출력값이 다음처럼 나올 수 있다.
tensor([
    [-1.72],
    [ 0.83],
    [ 2.31]
])
이 값 자체는 확률이 아니다.
즉,
- 음수라고 바로 0인 것도 아니고
- 양수라고 바로 1인 것도 아니며
- 0~1 사이 값으로 제한되어 있지도 않다.
이 모델의 원시 출력값을 Logit이라고 한다.
⠀
2. 이진분류에서 Logit이란?
처음 이진분류를 보면 가장 헷갈리는 부분이
"모델이 0 또는 1을 맞혀야 하는데 왜 출력값은 -2, 1.5 같은 숫자로 나오는가?"
였다.
신경망은 기본적으로 Linear Layer를 통과하면서 연속적인 값을 출력한다.
이 값을 바로 클래스라고 해석하지 않고, 이후 Sigmoid 같은 함수를 적용해 확률 형태로 변환한다.
즉 전체 흐름은 다음과 같다.
Input
↓
Model
↓
Logit
↓
Sigmoid
↓
Probability
↓
0 또는 1 Class
예를 들어 Logit이
2.0이라면 Sigmoid를 적용했을 때 약 0.88 정도가 된다.
반대로 Logit이
-2.0이라면 약 0.12 정도가 된다.
따라서 Logit은 최종 클래스가 아니라 클래스를 결정하기 전 단계의 원시 점수라고 생각하면 된다.
⠀
3. BCEWithLogitsLoss는 Logit을 그대로 입력한다
이번 실습에서는 이진분류의 Loss Function으로
nn.BCEWithLogitsLoss()를 사용했다.

Optimizer는 이전과 동일하게 SGD를 사용했다.
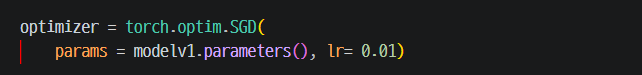
BCEWithLogitsLoss()에서 가장 중요한 점은 이름 그대로 Logit 값을 직접 입력받는다는 것이다.
즉 학습할 때는 다음과 같이 사용한다.
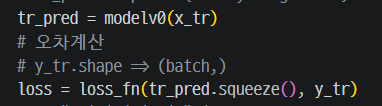
여기서 tr_pred에 Sigmoid를 먼저 적용하지 않는다.
📌 내가 헷갈리기 쉬운 부분
처음에는 이진분류니까 다음처럼 해야 할 것 같았다.
tr_pred = torch.sigmoid(modelv0(x_tr))
loss = loss_fn(tr_pred, y_tr)
하지만 BCEWithLogitsLoss()를 사용할 때는 이렇게 하면 안 된다.
BCEWithLogitsLoss() 내부에서 이미 Sigmoid + Binary Cross Entropy 계산을 한 번에 처리하기 때문이다.
따라서 학습 단계에서는
Logit → BCEWithLogitsLoss로 바로 연결한다.
⠀
4. BCEWithLogitsLoss를 사용하는 이유
이진분류에서는 Binary Cross Entropy 계열의 Loss를 사용할 수 있다.
PyTorch에는
nn.BCELoss()와
nn.BCEWithLogitsLoss()가 있는데 두 개의 차이를 이해하는 것이 중요했다.
BCELoss
BCELoss는 0~1 사이의 확률값을 입력으로 받기 때문에, 모델의 Logit에 Sigmoid를 먼저 적용한 뒤 Loss를 계산한다.
proba = torch.sigmoid(logit)

loss = nn.BCELoss()(proba, y)
BCEWithLogitsLoss
BCEWithLogitsLoss는 Sigmoid 연산이 내부에 포함되어 있기 때문에, 모델이 출력한 값을 그대로 Loss에 넣는다.
loss = nn.BCEWithLogitsLoss()(logit, y)실습에서는 BCEWithLogitsLoss()를 사용했다.
이때 코드에서 변수명이 꼭 logit일 필요는 없다.
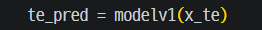
처럼 작성했더라도, Sigmoid를 적용하기 전 모델의 출력값 자체가 Logit이다.
따라서 이렇게 기억하면 된다.
Loss 계산 시 → 모델 출력(Logit)을 그대로 사용
예측 결과 확인 시 → Logit → Sigmoid → round → 0/1
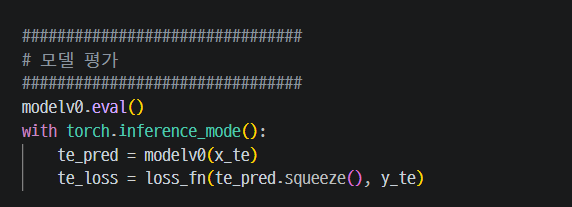
예를 들어 실습의 평가 과정은 다음과 같다.
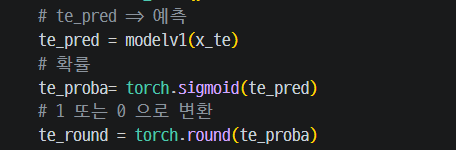
⠀
5. 실제 예측 결과를 볼 때는 Sigmoid를 사용한다
Loss를 계산할 때는 Logit을 그대로 사용했지만,
모델이 실제로 0을 예측했는지 1을 예측했는지 확인하려면 Logit을 그대로 사용할 수 없다.
따라서 평가 단계에서는 Sigmoid를 적용한다.
modelv0.eval()

with torch.inference_mode():
    te_pred = modelv0(x_te)
    te_proba = torch.sigmoid(te_pred)
Sigmoid는 어떤 값을 입력받더라도 출력값을 0~1 사이의 값으로 변환한다.
예를 들어
Logit = -2.0이라면
Sigmoid ≈ 0.12이고,
Logit = 2.0이라면
Sigmoid ≈ 0.88정도가 된다.
따라서 이 값을 1이라는 클래스일 확률처럼 해석할 수 있다.
⠀
6. Logit → Sigmoid → round
Sigmoid를 적용하면 값이 0~1 사이로 변하지만 아직 최종 클래스는 아니다.
예를 들어
0.21
0.67
0.91
0.48
과 같은 값이 나온다.
따라서 torch.round()를 이용해 0 또는 1로 변환한다.
te_round = torch.round(te_proba)전체 흐름은 다음과 같다.
단계의미
| Logit | 모델의 원시 출력 |
| Sigmoid | Logit을 0~1 범위로 변환 |
| Probability | 클래스 1에 가까운 정도 |
| round | 0 또는 1의 최종 예측값으로 변환 |
즉 평가할 때는
te_pred = modelv0(x_te)
te_proba = torch.sigmoid(te_pred)
te_round = torch.round(te_proba)
의 흐름을 사용한다.
📌 Loss 계산과 클래스 예측을 구분해서 기억하기
학습할 때
Logit → BCEWithLogitsLoss실제 예측 클래스를 볼 때
Logit → Sigmoid → round이 둘을 구분하는 것이 이번 파트에서 가장 중요했다.
⠀
7. 왜 기준이 0.5인가?
Sigmoid를 적용하면 값이 0~1 사이로 변한다.
torch.round()를 적용하면 일반적으로
0.5보다 작음 → 0
0.5보다 큼 → 1
으로 분류된다.
따라서 다음과 같은 의미로 볼 수 있다.
Sigmoid = 0.13 → Class 0
Sigmoid = 0.42 → Class 0
Sigmoid = 0.73 → Class 1
Sigmoid = 0.94 → Class 1
즉 모델이 클래스 1일 가능성이 높다고 판단하면 1이 되고, 반대라면 0이 된다.
다만 실제 프로젝트에서는 상황에 따라 Threshold를 반드시 0.5로 고정하지 않고 조정할 수도 있다.
이번 실습에서는 Sigmoid 출력값을 torch.round()로 0 또는 1로 변환했다.
실질적으로 0.5 부근을 기준으로 두 클래스를 구분하는 방식이며, 실제 프로젝트에서는 threshold를 별도로 지정할 수도 있다.
⠀
8. Accuracy가 이상하면 Shape부터 확인하기
이번 실습에서 특히 헷갈렸던 부분 중 하나가 Tensor의 Shape이었다.
모델의 예측 결과는 보통 다음과 같은 Shape으로 나왔다.
(batch, 1)예를 들어
torch.Size([200, 1])정답은 다음과 같은 형태였다.
(batch,)즉
torch.Size([200])였다.
숫자의 개수는 둘 다 200개이기 때문에 처음에는 같은 것처럼 보이지만,
(200, 1)과
(200,)은 서로 다른 Shape이다.
이 상태에서 torch.eq() 등을 사용하면 의도한 1:1 비교가 아니라 Broadcasting이 발생할 수 있다.
⠀
9. Broadcasting 때문에 Accuracy가 이상해질 수 있다
예를 들어 다음 두 Tensor가 있다고 하자.
y_pred.shape
# torch.Size([200, 1])
y_true.shape
# torch.Size([200])사람이 보기에는 200개의 예측값과 200개의 정답이니까 그대로 비교해도 될 것 같지만,
PyTorch에서는 Shape이 다르기 때문에 예상과 다른 방식으로 연산될 수 있다.
이때 예측 Tensor에
.squeeze()를 적용했다.
te_round.squeeze()그러면
(200, 1)이
(200,)으로 바뀐다.
따라서 정답과 동일한 Shape으로 만들 수 있다.
⠀
10. squeeze()는 무엇을 하는가
squeeze()는 크기가 1인 차원을 제거하는 함수이다.
예를 들어
tensor.shape
# torch.Size([200, 1])
에서
tensor.squeeze().shape을 확인하면
torch.Size([200])이 된다.
즉
(200, 1)
↓
(200,)
으로 바뀌는 것이다.
이번 실습에서는 다음 두 곳에서 Shape을 맞출 필요가 있었다.
Loss 계산
loss = loss_fn(
    tr_pred.squeeze(),
    y_tr
)
Accuracy 계산
accuracy = accuracy_fn(
    y_true=y_te,
    y_pred=te_round.squeeze()
)
📌 이번 실습에서 실제로 확인한 오류
Accuracy 값이 이상하게 나오거나 Tensor 비교 결과가 예상과 다르면 계산식만 확인하기보다 먼저
print(y_pred.shape)
print(y_true.shape)
를 확인하는 것이 좋다.
딥러닝에서는 값 자체도 중요하지만 Tensor Shape이 맞는지가 정말 중요하다.
⠀
11. Accuracy 함수 직접 만들어보기
이번 실습에서는 예측 결과와 실제값이 같은 개수를 세어 Accuracy를 계산했다.
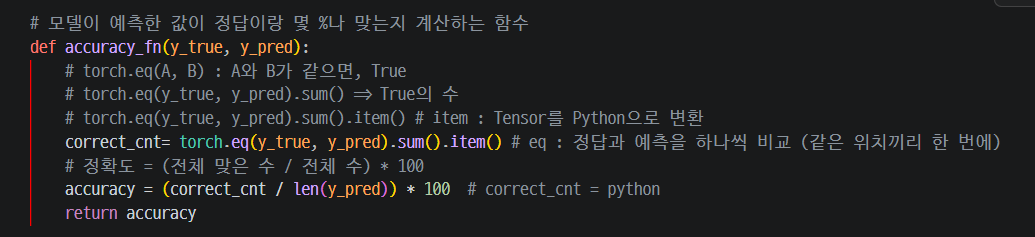
순서대로 보면
torch.eq(y_true, y_pred)에서 각 위치의 값이 같은지 비교한다.
예를 들어
y_true = [0, 1, 1, 0]
y_pred = [0, 1, 0, 0]
이라면
[True, True, False, True]와 같은 결과가 나온다.
이후
.sum()을 사용하면 True의 개수를 셀 수 있고,
.item()을 사용해 Tensor 값을 일반 숫자로 가져온다.
마지막으로
correct_cnt / len(y_pred)를 통해 전체 데이터 중 몇 개를 맞혔는지 계산한다.
⠀
12. 전체 이진분류 Training Loop
전체 흐름을 다시 보면 이전 Regression Training Loop와 크게 다르지 않다.
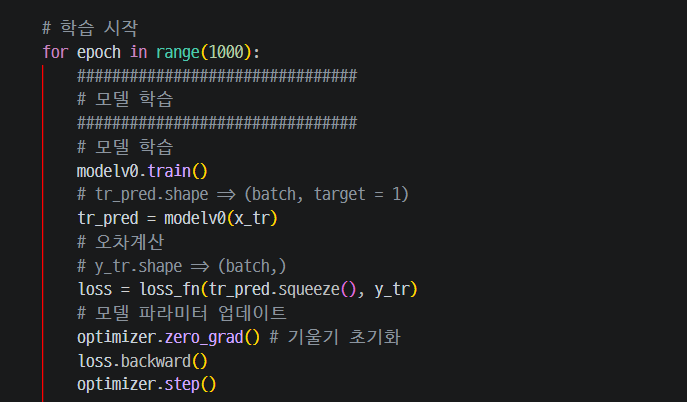
Regression에서 사용했던
Forward
→ Loss
→ zero_grad
→ backward
→ step
의 흐름은 그대로 유지된다.
달라지는 부분은 주로
- 어떤 Loss Function을 사용하는지
- 모델의 출력을 어떻게 해석하는지
- 최종 클래스 예측값을 어떻게 만드는지
이다.
즉 모델 학습의 큰 구조는 동일하고, 문제 유형에 따라 출력값과 Loss를 해석하는 방법이 달라진다.
⠀
13. Training Loop에서 Accuracy까지 계산하면
이진분류에서는 모델이 출력한 값을 바로 0과 1로 비교할 수 없다.
모델의 출력값은 Sigmoid를 적용하기 전의 Logit이므로, 실제 예측 클래스를 확인하려면 먼저 확률값으로 변환해야 한다.
실습에서는 다음과 같이 평가했다.

여기서 sigmoid()는 모델의 출력값을 0~1 사이의 확률로 바꾸고, round()는 이를 최종 클래스인 0 또는 1로 변환한다.
또한 모델의 출력 shape이 (데이터 수, 1)이고 정답의 shape이 (데이터 수,)라면 squeeze()를 사용해 두 shape을 맞춰준다.
즉 평가 과정은 다음과 같이 정리할 수 있다.
Logit → Sigmoid → 확률 → round → 0/1 → Accuracy 계산
⠀
14. 그런데 Linear Layer만으로 Circle 데이터를 잘 분류할 수 있을까?
이번 Circle 데이터는 이름 그대로 원형 형태로 분포되어 있다.
따라서 단순한 직선 하나만으로 두 클래스를 나누기 어렵다.
초기 모델은
nn.Linear(...)
nn.Linear(...)
처럼 Linear Layer만 연결한 구조였다.
그런데 Linear Layer를 여러 개 연결하더라도 중간에 Activation Function이 없다면 전체적으로는 결국 선형적인 변환으로 표현된다.
즉 복잡한 경계를 만들기 어렵다.
그래서 이후 모델에서는 ReLU 같은 비선형 Activation Function을 추가하게 된다.
예를 들어
nn.Sequential(
    nn.Linear(2, 10),
    nn.ReLU(),
    nn.Linear(10, 10),
    nn.ReLU(),
    nn.Linear(10, 1)
)
처럼 사용할 수 있다.
이 부분은 이후 실습에서 모델의 표현력을 높이는 핵심이 된다.
📌 중요한 연결
Linear Layer를 여러 개 쌓는 것과
Non-linear Activation Function을 추가하는 것은 같은 의미가 아니다.
복잡한 데이터의 Decision Boundary를 학습하려면 비선형성이 필요하다.
⠀
15. 이번 실습의 전체 흐름
이번 이진분류 실습의 흐름을 정리하면 다음과 같다.
Circle 데이터 생성
↓
Train / Test 분리
↓
모델 생성
↓
모델에서 Logit 출력
↓
BCEWithLogitsLoss로 Loss 계산
↓
Backward
↓
Optimizer로 파라미터 업데이트
↓
Evaluation
↓
Logit에 Sigmoid 적용
↓
round로 0 / 1 변환
↓
squeeze로 Shape 맞추기
↓
Accuracy 계산
결국 이번 실습의 핵심은 단순히 이진분류 모델을 만드는 것이 아니라,
모델이 출력한 값을 학습할 때와 평가할 때 각각 어떻게 사용해야 하는지 이해하는 것이었다.
⠀
16. 핵심 정리
개념기억할 내용
| Binary Classification | 두 개의 클래스 중 하나를 예측 |
| Logit | 모델이 출력하는 원시 값 |
| BCEWithLogitsLoss | 학습 시 Logit을 그대로 입력 |
| Sigmoid | Logit을 0~1 범위로 변환 |
| Probability | 클래스 1에 가까운 정도 |
| round | 확률값을 0 또는 1로 변환 |
| squeeze | 크기가 1인 차원을 제거 |
| Broadcasting | Shape이 다를 때 자동으로 연산 형태가 확장되는 현상 |
| Accuracy | 실제값과 예측값이 같은 비율 |
| ReLU | 모델에 비선형성을 추가 |
이번 파트에서 가장 헷갈리지 않게 기억해야 할 흐름은 다음과 같다.
학습할 때
Model → Logit → BCEWithLogitsLoss실제 예측 결과를 확인할 때
Model → Logit → Sigmoid → round → Class그리고 Accuracy가 이상하게 나오면 가장 먼저
예측값 Shape == 정답 Shape ?를 확인하는 것이 좋다.
이진분류에서는 Loss Function만 이해하는 것이 아니라 Logit, Probability, Class를 각각 구분해서 보는 것과 Tensor Shape을 맞추는 것이 중요하다는 점을 이번 실습에서 확실히 알 수 있었다.
'개발 공부 > 딥러닝' 카테고리의 다른 글
| [Deep Learning] PyTorch DataLoader로 Mini-batch 학습하기 | 손글씨 숫자 이진분류 (0) | 2026.09.26 |
|---|---|
| [Deep Learning] 레이어를 늘렸는데 왜 학습이 안 될까? | 선형 모델의 한계와 ReLU (0) | 2026.09.26 |
| [Deep Learning] PyTorch 모델 학습의 전체 흐름 | Loss, Optimizer, Training Loop와 모델 저장 (0) | 2026.09.26 |
| [Deep Learning] PyTorch 모델 구조를 단순화하고 예측값 해석하기 (0) | 2026.09.26 |
| [Deep Learning] PyTorch 신경망 모델 직접 만들기 (0) | 2026.09.26 |