모델의 Layer와 Parameter를 늘리는 것만으로는 모든 문제가 해결되지 않는다.
ex11에서는 원형 데이터를 Linear Layer만으로 학습했을 때 성능이 거의 좋아지지 않았고,
비선형 Activation Function인 ReLU를 추가한 뒤 차이가 나타났다.
이번 실습을 통해 단순히 모델을 더 크게 만드는 것보다, 현재 모델이 데이터의 패턴을 표현할 수 있는 구조인지 확인하는 것이 중요하다는 점을 확인할 수 있었다.
#ActivationFunction #ReLU #NonLinear #Underfitting #NeuralNetwork #PyTorch #딥러닝공부
⠀
1. 첫 번째 가설: 모델을 더 복잡하게 만들면 좋아질까?
Base Model의 성능이 좋지 않자 ex11에서는 Hidden Layer를 추가해 모델을 더 복잡하게 만들었다.
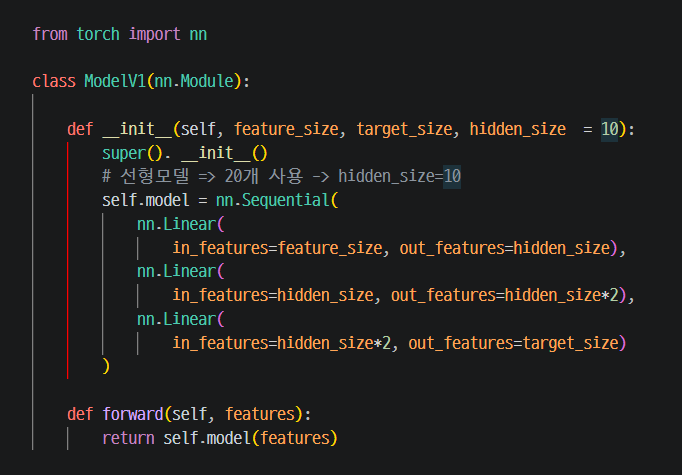
처음에는 Layer 수를 늘리고 Parameter를 더 많이 사용하면 모델의 표현력이 커지기 때문에 성능도 자연스럽게 좋아질 것이라고 생각할 수 있다.
하지만 실제로는 Layer를 추가하고 더 오래 학습해도 Circle 데이터를 제대로 분류하지 못했다.
즉 단순히
Layer 수 증가
또는
Epoch 증가
만으로는 문제가 해결되지 않았다.
📌 실습에서 확인한 점
학습 횟수와 Layer 수를 늘리는 것만으로는 해결되지 않았다.
문제는 모델이 얼마나 큰가보다, 데이터가 가진 패턴을 현재 구조가 표현할 수 있는가에 있었다.
⠀
2. Circle 데이터는 직선 하나로 나누기 어렵다
이번 실습에서 사용한 데이터는 make_circles()로 만든 원형 데이터였다.
즉 두 클래스가 단순히 왼쪽과 오른쪽으로 나뉘는 형태가 아니라,
한 클래스가 안쪽 원을 이루고 다른 클래스가 바깥쪽을 둘러싸는 형태다.
이런 데이터는 하나의 직선으로 두 클래스를 나누기 어렵다.
Binary Classification 추가 강의자료에서도 선형 모델을 Circle 데이터에 적용했을 때 Accuracy가 약 50% 부근에 머무는 모습을 확인했다.
Accuracy가 50% 근처라는 것은 이진분류에서는 거의 랜덤하게 맞히는 수준에 가깝다고 볼 수 있다.
이 상태는 모델이 데이터의 패턴을 충분히 학습하지 못하는 Underfitting 상태로 볼 수 있다.
⠀
3. Linear Layer를 여러 개 쌓아도 왜 해결되지 않을까?
여기서 처음에는 조금 의문이 들었다.
Linear Layer를 하나만 사용하는 것이 아니라 여러 개 연결했다면,
모델도 충분히 복잡해진 것 아닌가 생각할 수 있다.
하지만 중요한 점은 Linear Layer 사이에 Activation Function이 없다는 것이다.
예를 들어
Linear
↓
Linear
↓
Linear
처럼 Linear Layer만 여러 개 연결하면, 각 Layer에서는 다음과 같은 선형 변환이 반복된다.
y = Wx + b그런데 선형 변환을 여러 번 연속으로 적용하더라도 전체 결과는 다시 하나의 선형 변환으로 정리할 수 있다.
개념적으로 보면,
Linear(Linear(x))도 결국
새로운 Linear(x)처럼 표현될 수 있다.
즉 Layer는 여러 개가 되었지만 모델이 표현할 수 있는 함수 자체는 여전히 선형적인 범위에 머무르게 된다.
📌 내가 헷갈리기 쉬운 부분
Layer가 많다 = 무조건 비선형 모델
은 아니다.
Linear Layer 사이에 비선형 Activation Function이 없다면,
Layer를 여러 개 쌓더라도 전체 모델은 선형적인 표현에서 벗어나기 어렵다.
⠀
4. 선형 모델의 Decision Boundary
Classification에서 모델은 두 클래스를 구분하는 경계를 학습한다.
이 경계를 Decision Boundary라고 한다.
선형 모델이 만들 수 있는 Decision Boundary는 기본적으로 직선 또는 고차원에서의 평면과 같은 형태다.
예를 들어 다음과 같이 두 그룹이 나뉘어 있다면,
○ ○ ○ | ● ● ●
○ ○ ○ | ● ● ●
직선 하나만으로도 충분히 분류할 수 있다.
하지만 Circle 데이터는
바깥쪽 클래스
   ○ ○ ○ ○
 ○         ○
 ○    ●    ○
 ○         ○
   ○ ○ ○ ○
처럼 한 클래스가 다른 클래스를 둘러싼 구조다.
이 경우 하나의 직선으로 두 그룹을 정확히 분리하는 것은 어렵다.
따라서 Circle 데이터를 제대로 학습하려면 곡선처럼 복잡한 Decision Boundary를 표현할 수 있는 구조가 필요하다.
⠀
5. 해결: Linear 사이에 ReLU 추가
ex11의 ModelV2에서는 Linear Layer 사이에 ReLU를 추가해 모델을 비선형 구조로 바꿨다.
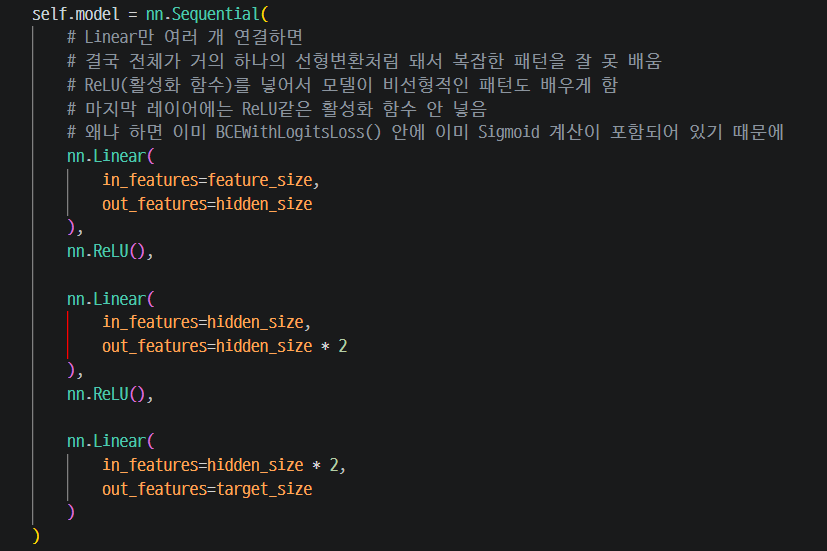
Linear Layer 사이에 ReLU를 추가하면서 이전 모델과 가장 큰 차이가 생겼다.
기존 구조
Linear
↓
Linear
↓
Linear
변경된 구조
Linear
↓
ReLU
↓
Linear
↓
ReLU
↓
Linear
즉 단순히 Layer 개수를 늘린 것이 아니라,
중간에 비선형 변환을 추가한 것이 핵심이다.
⠀
6. ReLU는 어떤 함수인가
ReLU는 Rectified Linear Unit의 약자로, 딥러닝에서 많이 사용하는 Activation Function이다.
기본적인 동작은 다음과 같다.
ReLU(x) = max(0, x)즉,
x < 0  → 0
x > 0  → x 그대로
동작한다.
예를 들어
입력값      ReLU 출력

-3          0
-1          0
 0          0
 2          2
 5          5
처럼 변환된다.
겉으로 보면 단순히 음수를 0으로 만드는 함수처럼 보이지만,
신경망에서는 이 과정이 매우 중요하다.
Linear Layer 사이에 ReLU가 들어가면서 각 Layer의 관계가 단순한 선형 관계에서 벗어나기 때문이다.
⠀
7. ReLU를 넣으면 무엇이 달라질까?
ReLU 자체가 Circle 모양의 경계를 직접 만들어주는 것은 아니다.
중요한 점은 ReLU가 모델에 비선형성(Non-Linearity)을 추가한다는 것이다.
Linear Layer만 있을 때는 모델이 표현할 수 있는 관계가 제한적이지만,
Linear
↓
ReLU
↓
Linear
↓
ReLU
처럼 비선형 함수를 중간에 추가하면 여러 Linear 변환이 단순히 하나의 Linear 변환으로 합쳐지지 않는다.
따라서 모델이 훨씬 다양한 함수와 Decision Boundary를 표현할 수 있게 된다.
⠀
즉 ReLU의 역할은
모델이 복잡한 데이터 패턴을 학습할 수 있도록 표현력을 확장하는 것
이라고 볼 수 있다.
⠀
📌 중요한 연결
ReLU를 넣었다고 Circle 형태를 자동으로 학습하는 것이 아니라,
Circle과 같은 비선형 패턴을 학습할 수 있는 가능성을 만들어주는 것이다.
⠀
8. 왜 마지막 Layer 뒤에는 ReLU를 넣지 않았을까?
ModelV2의 구조를 보면 마지막 Linear Layer 뒤에는 ReLU가 없다.
nn.Linear(
    in_features=hidden_size * 2,
    out_features=target_size
)
이유는 이번 이진분류에서 마지막 출력값으로 Logit을 사용하기 때문이다.
앞에서 사용했던
nn.BCEWithLogitsLoss()는 모델이 출력한 Logit을 그대로 입력받는다.
그런데 마지막 출력에 ReLU를 적용하면 모든 음수 Logit이 0으로 바뀐다.
이렇게 되면 모델이 표현할 수 있는 Logit 범위가 제한될 수 있다.
따라서 이번 실습에서는
Hidden Layer 사이
→ ReLU 사용

Final Output
→ Linear 출력 그대로 사용
하는 구조를 사용했다.
그리고 최종 예측 결과가 필요할 때 별도로 Sigmoid를 적용했다.
Linear Output
↓
Logit
↓
Sigmoid
↓
Probability
즉 Hidden Layer의 Activation Function과 Output Layer의 처리 방식은 구분해서 생각해야 한다.
⠀
9. 모델을 고칠 때는 원인부터 확인하기
이번 실습의 흐름은
Base Model → Layer 추가 → 그래도 실패 → 비선형성 추가
순서였다.
성능이 낮으면 처음에는
Epoch를 더 늘려볼까?
Layer를 더 추가할까?
Hidden Size를 키워볼까?
처럼 모델을 무조건 크게 만드는 방향부터 생각하기 쉽다.
하지만 이번 예제에서는 학습 횟수가 부족했던 것이 핵심 문제가 아니었다.
Circle이라는 비선형 데이터를 선형 모델로 풀려고 했던 구조적인 문제가 핵심이었다.
따라서 모델 성능이 좋지 않을 때는 단순히 복잡도를 높이기 전에 다음 순서로 확인해볼 수 있다.
1. 데이터는 어떤 형태인가?
↓
2. 현재 모델이 그 형태를 표현할 수 있는가?
↓
3. Loss Function은 문제에 적절한가?
↓
4. Optimizer와 Learning Rate는 적절한가?
↓
5. 그 이후 Layer, Hidden Size, Epoch 등을 조정
즉 모델을 크게 만드는 것보다 먼저 왜 학습이 안 되는지 원인을 찾는 과정이 중요하다.
⠀
10. V0 → V1 → V2 비교
이번 실습을 모델별로 정리하면 다음과 같다.
모델변경 내용확인한 내용
| V0 | 기본 Linear 구조 | Circle 데이터를 충분히 학습하지 못함 |
| V1 | Linear Layer 추가 | Parameter와 Layer를 늘려도 큰 개선이 없음 |
| V2 | ReLU 추가 | 비선형 패턴을 학습할 수 있는 구조로 변경 |
여기서 가장 중요한 차이는 V1과 V2다.
V1은 모델의 크기는 커졌지만 여전히 Linear Layer만 사용했다.
반면 V2는 ReLU를 추가하면서 모델이 비선형 관계를 표현할 수 있게 되었다.
따라서 모델의 복잡도는 단순히 Parameter 수만으로 결정되는 것이 아니라,
어떤 연산과 Activation Function을 사용하는지도 중요하다는 것을 알 수 있었다.
⠀
11. Underfitting이란
이번 실습에서 선형 모델은 Circle 데이터를 충분히 학습하지 못했다.
이처럼 모델이 데이터 안의 패턴을 제대로 학습하지 못하는 상태를 Underfitting이라고 한다.
Underfitting이 발생하면 Train 데이터에서도 성능이 충분히 높지 않은 경우가 많다.
원인은 여러 가지가 있을 수 있다.
- 모델 구조가 지나치게 단순한 경우
- 학습 횟수가 부족한 경우
- Feature가 부족한 경우
- 데이터 패턴과 모델 구조가 맞지 않는 경우
이번 실습에서는 그중에서도
비선형 데이터를 선형 모델로 학습하려고 한 것
이 핵심 원인이었다.
따라서 Underfitting이 발생했다고 해서 무조건 Layer만 늘리는 것이 아니라,
왜 모델이 패턴을 학습하지 못하는지 원인을 구분해서 보는 것이 중요하다.
⠀
12. 이번 실습에서 배운 흐름
이번 내용을 전체적으로 정리하면 다음과 같다.
Circle 데이터 생성
↓
Linear Base Model 학습
↓
Accuracy가 크게 개선되지 않음
↓
Linear Layer 추가
↓
여전히 비선형 패턴을 표현하지 못함
↓
원인 확인
↓
Circle 데이터는 선형적으로 분리하기 어려움
↓
ReLU 추가
↓
모델에 비선형성 추가
↓
복잡한 Decision Boundary 학습 가능
이번 실습에서 가장 기억에 남는 부분은
모델을 복잡하게 만든다고 항상 성능이 좋아지는 것은 아니라는 점이었다.
Linear Layer를 여러 개 쌓고 Epoch를 늘려도 데이터의 형태를 모델이 표현할 수 없다면 학습에는 한계가 있다.
결국 모델 구조를 정할 때는 단순히 Layer 수를 늘리는 것이 아니라,
문제 자체가 선형적인지 비선형적인지, 그리고 현재 모델이 그 관계를 표현할 수 있는지 확인하는 과정
이 중요하다.
⠀
13. 핵심 정리
개념기억할 내용
| Underfitting | 모델이 데이터의 패턴을 충분히 학습하지 못한 상태 |
| Linear Layer | 선형 변환을 수행 |
| Layer 추가 | 모델 크기는 증가하지만 비선형성 자체를 만들지는 않음 |
| Activation Function | 모델에 비선형성을 추가 |
| ReLU | 음수는 0, 양수는 그대로 출력 |
| Non-Linearity | 복잡한 데이터 패턴을 표현할 수 있도록 함 |
| Decision Boundary | 클래스 사이를 나누는 경계 |
| Circle 데이터 | 단순한 직선으로 분류하기 어려운 비선형 데이터 |
| Final Layer | ex11에서는 ReLU 없이 Logit을 그대로 출력 |
이번 파트에서 가장 중요한 내용을 한 문장으로 정리하면,
Linear Layer를 많이 쌓는 것과 비선형 모델을 만드는 것은 다르다.
모델의 성능이 좋지 않을 때 무조건 Layer나 Epoch를 늘리기보다,
먼저 현재 모델이 데이터의 구조를 표현할 수 있는지 확인해야 한다.