모델 구조를 만드는 것에서 끝나는 것이 아니라,
예측값으로 Loss를 계산하고 Gradient를 구해 파라미터를 실제로 업데이트하는 과정까지 연결해야 학습이 완성된다.
⠀
1. Loss Function과 Optimizer의 역할을 분리해서 보기
처음에는 Loss Function과 Optimizer가 둘 다 학습에 사용되다 보니 역할이 비슷하게 느껴질 수 있다.
하지만 실제로는 역할이 명확하게 나뉜다.
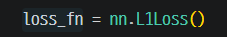
Loss Function은 현재 모델의 예측값이 실제값과 얼마나 차이나는지 계산하는 역할을 하고,
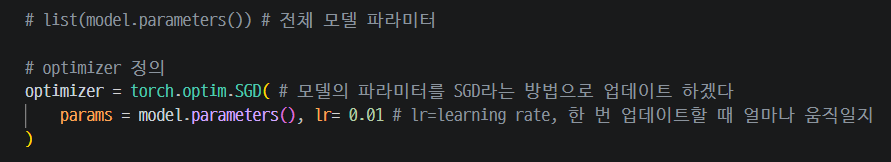
Optimizer는 그 Loss를 기준으로 계산된 Gradient를 사용해서 모델의 파라미터를 실제로 수정하는 역할을 한다.
| 구성 요소 | 역할 | 자료의 예시 |
| Loss Function | 예측값과 실제값의 차이를 계산 | nn.L1Loss(), nn.MSELoss() |
| Optimizer | 모델 파라미터 업데이트 | torch.optim.SGD, torch.optim.Adam |
| Learning Rate | 한 번 업데이트할 때 움직이는 정도 | lr=0.01 |
Learning Rate는 Optimizer가 파라미터를 업데이트할 때 얼마만큼 이동할지 결정하는 값이다.
너무 크면 최적의 값을 지나칠 수 있고,
너무 작으면 학습 속도가 지나치게 느려질 수 있기 때문에 적절한 값을 설정하는 것이 중요하다.
⠀
2. PyTorch Training Loop의 순서
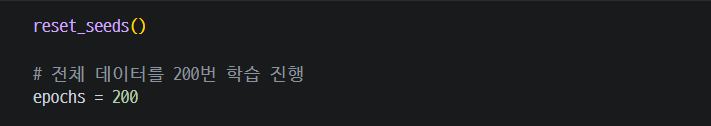
ex10의 핵심은 학습과 평가를 하나의 반복문 안에서 직접 작성하는 것이다.
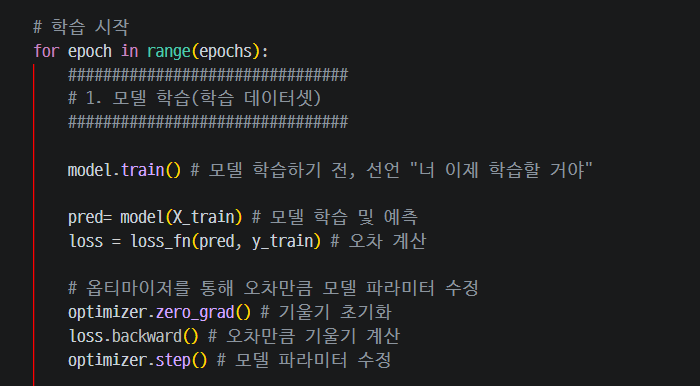
학습 단계에서는 모델이 예측을 수행하고, Loss를 계산한 뒤 Gradient를 구해서 파라미터를 수정한다.
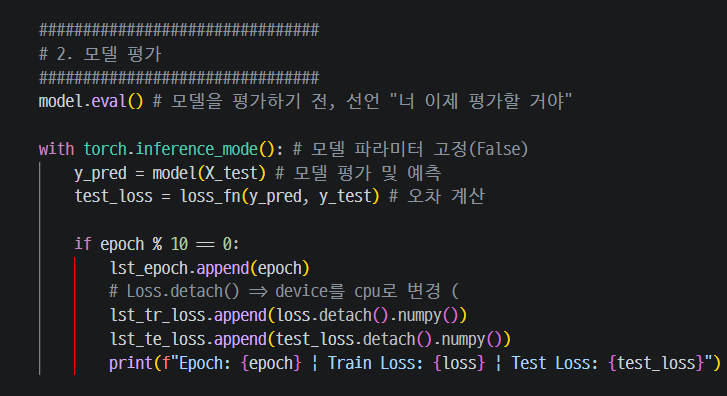
반대로 평가 단계에서는 이미 학습된 현재 모델의 성능을 확인하는 것이 목적이기 때문에 파라미터를 수정하지 않는다.
| 순서 | 코드 | 의미 |
| 1 | model.train() | 학습 모드로 전환 |
| 2 | pred = model(X_train) | Train 데이터로 예측 |
| 3 | loss = loss_fn(...) | 오차 계산 |
| 4 | optimizer.zero_grad() | Gradient 초기화 |
| 5 | loss.backward() | Gradient 계산 |
| 6 | optimizer.step() | 파라미터 업데이트 |
| 7 | model.eval() | 평가 모드로 전환 |
| 8 | torch.inference_mode() | 평가 시 Gradient 계산 없이 추론 |
여기서 특히 헷갈렸던 부분은 Loss를 계산하는 것과 모델이 실제로 학습되는 것은 별개의 과정이라는 점이다.
단순히
loss = loss_fn(pred, y_train)
까지 실행했다고 해서 모델의 Weight와 Bias가 자동으로 바뀌는 것은 아니다.
⠀
먼저
loss.backward()
를 실행해야 각 파라미터에 대해 Loss를 줄이기 위해 어느 방향으로 얼마나 움직여야 하는지 Gradient가 계산된다.
⠀
그리고 마지막으로
optimizer.step()
이 실행되어야 실제 파라미터 값이 변경된다.
⠀
즉,
Forward → Loss 계산 → Gradient 계산 → Parameter Update
이 흐름이 모두 진행되어야 한 번의 학습이 완료된다.
📌 내가 헷갈리기 쉬운 부분
loss.backward()가 파라미터를 수정하는 것이 아니다.
- backward() → Gradient 계산
- step() → 계산된 Gradient를 이용해 실제 파라미터 수정
이 둘의 역할을 분리해서 기억하는 것이 중요하다.
⠀
3. optimizer.zero_grad()를 매번 실행하는 이유
PyTorch에서는 loss.backward()를 실행하면 계산된 Gradient가 각 파라미터의 .grad에 저장된다.
문제는 이 Gradient가 새로운 Epoch가 시작됐다고 자동으로 초기화되지 않는다는 점이다.
따라서 이전 Gradient가 남아 있는 상태에서 다시 backward()를 실행하면 Gradient가 계속 누적된다.
⠀
그래서 일반적인 Training Loop에서는 다음 순서를 사용한다.
optimizer.zero_grad()
→ 이전 Gradient 초기화
loss.backward()
→ 현재 Loss 기준 Gradient 계산
optimizer.step()
→ 파라미터 업데이트
즉, zero_grad()는 이번 학습에서 계산할 Gradient만 사용하기 위해 이전 값을 비워주는 과정이라고 보면 된다.
⠀
4. model.train()과 model.eval()을 나누는 이유
처음에는 model.train()과 model.eval()이 단순히 학습과 평가를 구분하는 표시라고 생각하기 쉽다.
하지만 실제로는 모델 내부의 일부 Layer의 동작 방식에 영향을 준다.
대표적으로 Dropout이나 Batch Normalization 같은 Layer는 학습 중과 평가 중 동작 방식이 다르다.
⠀
따라서 학습할 때는 : model.train()
평가할 때는 : model.eval()
을 명시적으로 호출하는 것이 좋다.
이번 예제처럼 단순한 Linear Regression에서는 두 모드의 차이가 크게 보이지 않을 수도 있지만,
나중에 더 복잡한 신경망을 사용할 때는 중요한 부분이다.
⠀
5. 평가할 때 torch.inference_mode()를 사용하는 이유
평가 단계에서는 모델의 성능만 확인하면 되기 때문에 Gradient를 계산할 필요가 없다.
그래서 다음과 같이 사용한다.
with torch.inference_mode():
이 구간에서는 Gradient 계산을 하지 않기 때문에 불필요한 연산을 줄일 수 있고 메모리 사용량도 줄일 수 있다.
즉,
- Training → Gradient 필요
- Test / Inference → Gradient 불필요
라고 생각하면 이해하기 쉽다.
⠀
⠀
⠀
6. Train Loss와 Test Loss를 함께 저장하는 이유
자료에서는 Epoch마다 Train Loss와 Test Loss를 저장한 뒤 그래프로 비교했다.
단순히 최종 Loss 하나만 확인하는 것보다,
학습이 진행되는 동안 두 Loss가 어떻게 변하는지를 확인하면 모델의 학습 상태를 훨씬 쉽게 파악할 수 있다.
정상적으로 학습되고 있다면 Train Loss와 Test Loss가 함께 감소하는 모습을 기대할 수 있다.

반대로 Train Loss는 계속 감소하는데 Test Loss가 어느 순간부터 증가한다면,
모델이 Train 데이터에만 지나치게 맞춰지는 Overfitting을 의심할 수 있다.
따라서 Loss 그래프는 단순히 값이 얼마나 작은지만 보는 것이 아니라,
Train과 Test의 차이가 어떻게 변하는지 함께 보는 것이 중요하다.
⠀
7. 학습한 모델은 state_dict로 저장한다
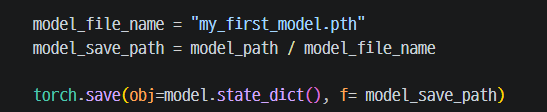
ex10과 Regression 강의자료에서는 학습이 끝난 모델의 파라미터를 state_dict 형태로 저장한 뒤,
새 모델 객체를 생성하고 load_state_dict()로 다시 적용하는 흐름을 사용했다.
PyTorch에서 state_dict에는 학습된 Weight와 Bias 등의 파라미터가 저장된다.
즉, 모델의 구조 자체를 저장한다기보다 학습을 통해 얻어진 파라미터 값들을 저장하는 방식이다.
전체 흐름은 다음과 같다.
모델 학습
↓
state_dict 저장
↓
동일한 구조의 새 모델 생성
↓
load_state_dict()로 학습된 파라미터 적용
↓
model.eval()
↓
추론
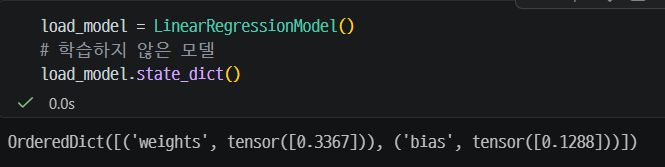
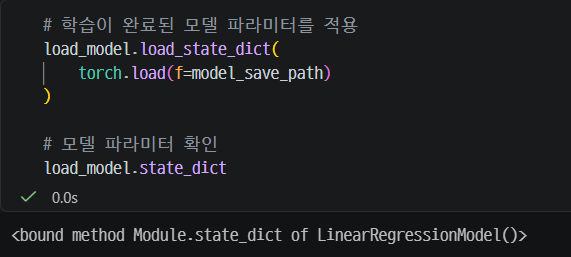
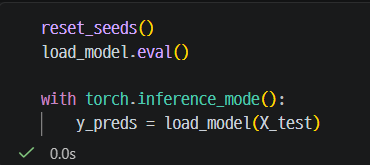
새로운 모델 객체를 만들었다고 해서 이전에 학습한 결과가 자동으로 들어가는 것은 아니다.
같은 모델 구조를 다시 만든 뒤 저장했던 state_dict를 불러와야 학습된 모델을 다시 사용할 수 있다.
📌 여기서도 기억할 점은
Model 구조와 Model Parameter는 별개라는 것이다.
모델 클래스로 구조를 먼저 만들고,
그 구조 안에 저장된 Weight와 Bias를 다시 불러오는 방식이다.
⠀
8. 이번 실습의 전체 흐름
이번 내용을 하나의 흐름으로 정리하면 다음과 같다.
모델 생성
↓
Train 데이터 입력
↓
예측값 계산
↓
Loss 계산
↓
Gradient 초기화
↓
Backward로 Gradient 계산
↓
Optimizer로 파라미터 업데이트
↓
Test 데이터로 평가
↓
Train / Test Loss 확인
↓
학습 완료 후 state_dict 저장
결국 PyTorch의 학습은 단순히 모델을 선언하는 것이 아니라,
이 과정을 Epoch마다 반복하면서 Loss가 작아지는 방향으로 모델의 파라미터를 조금씩 수정하는 과정이라고 볼 수 있다.
⠀
5. 핵심 정리
| 개념 | 기억할 내용 |
| Random Seed | 같은 조건에서 실험을 비교하기 위해 난수를 고정 |
| Loss | 예측과 실제의 차이를 계산 |
| backward() | Loss를 기준으로 Gradient 계산 |
| step() | 계산된 Gradient로 파라미터 업데이트 |
| eval() | 평가 모드로 전환 |
| state_dict | 학습된 모델 파라미터를 저장/불러올 때 사용 |
이번 파트에서 가장 중요한 것은 결국
Loss를 계산했다고 학습이 끝나는 것이 아니라,
Backward를 통해 Gradient를 계산하고 Optimizer가 실제 파라미터를 업데이트해야 한다는 점이다.
Training Loop 전체 흐름을 이해해두면 이후 Classification이나 더 복잡한 Neural Network 학습 코드를 볼 때도 구조 자체는 거의 동일하게 따라갈 수 있다.
'개발 공부 > 딥러닝' 카테고리의 다른 글
| [Deep Learning] 레이어를 늘렸는데 왜 학습이 안 될까? | 선형 모델의 한계와 ReLU (0) | 2026.09.26 |
|---|---|
| [Deep Learning] PyTorch 이진분류 | BCEWithLogitsLoss, Sigmoid와 squeeze가 필요한 이유 (0) | 2026.09.26 |
| [Deep Learning] PyTorch 모델 구조를 단순화하고 예측값 해석하기 (0) | 2026.09.26 |
| [Deep Learning] PyTorch 신경망 모델 직접 만들기 (0) | 2026.09.26 |
| [Deep Learning] 시계열 Dataset에 MinMax Scaling 적용하기 (0) | 2026.09.26 |